 Vastrik
咱们还是拿奥列格举例。
假设奥列格想买辆车,正在算得攒多少钱。他在网上翻了十来条卖车广告,发现新车大约 2 万美元,一年车龄的大约 1.9 万,两年的 1.8 万,以此类推。
分析师奥列格在脑子里得出了公式:一辆车的合理价格从 2 万美元起,每年跌 1000 美元,直到跌到 1 万美元为止。
奥列格做的事,在机器学习里叫回归:根据已知数据预测价格。人一直都在干这事,比如琢磨旧 iPhone 卖多少合适,又比如算去乡下度假得带多少肉串(我的公式是每人每天半公斤)。
要是世上每个问题都有个公式,那当然方便。可还拿车价来说:除了里程,还有几十种配置,车况各不相同,需求分淡旺季,更别说那些不容易察觉的因素。奥列格就算再上心,光靠脑子也顾不过来。
人又笨又懒,还是得让机器人卖力气。让机器看看我们的数据,从里面找出规律,学着替我们预测答案。最有意思的是,到头来它连人压根儿没想到的规律都找出来了。
机器学习就这么诞生了。
机器学习的目标,是根据输入数据预测结果。输入数据越丰富多样,机器就越容易找到规律,结果也越准。
所以,要教会机器,得有三样东西:
数据 想识别垃圾邮件?得有垃圾邮件的样本。想预测股价?得有历史价格。想知道用户的兴趣?得看他点过的赞、发过的帖。数据越多越好。几万条样本,那是实在没辙了才敢碰的底线。
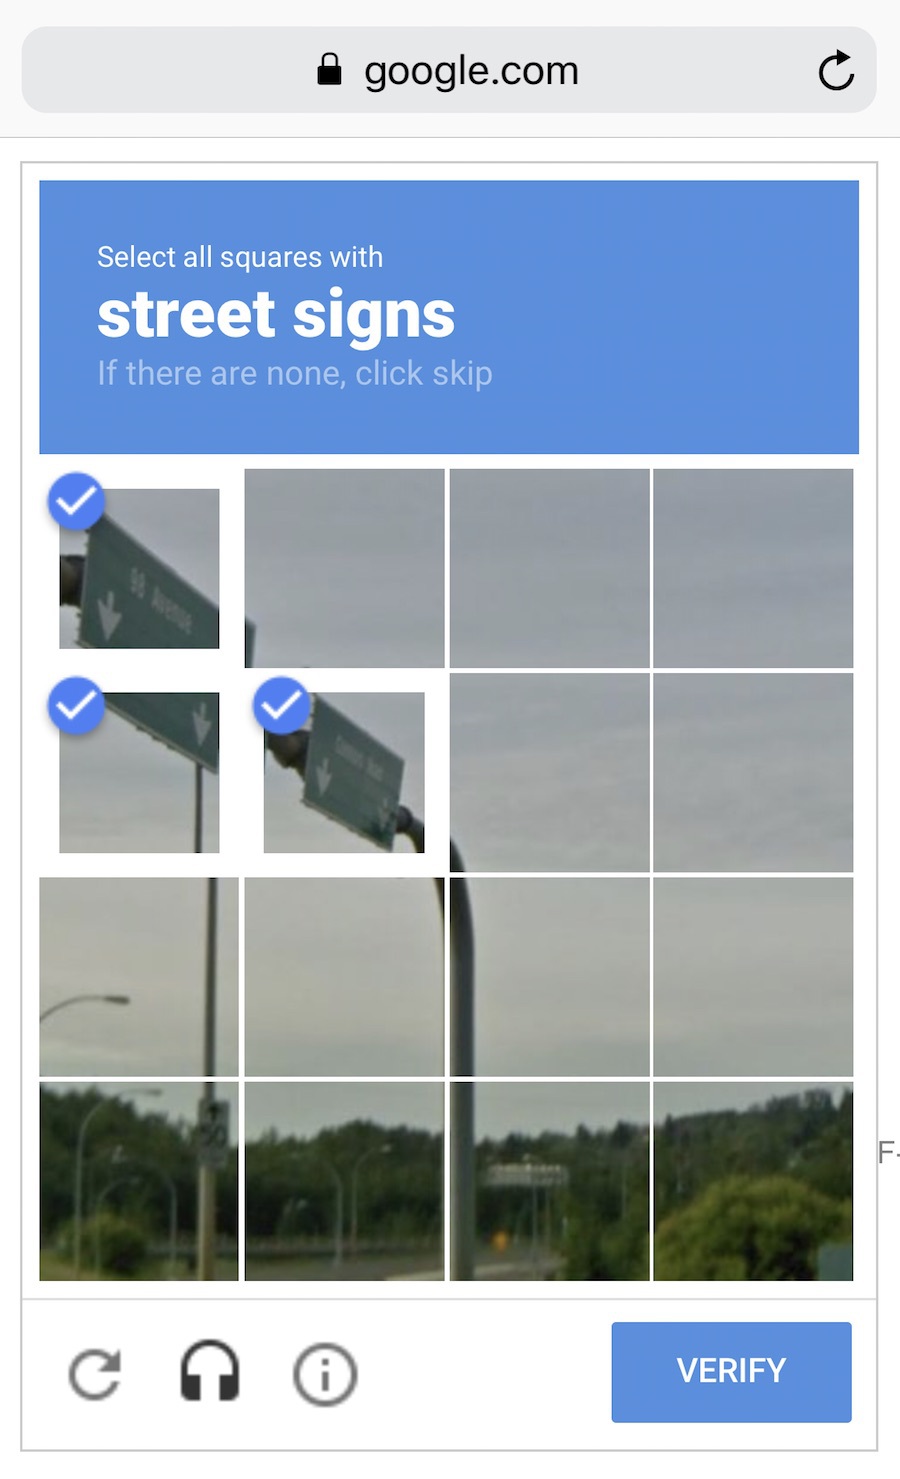
收集数据,大家各显神通。有人手工收集:速度慢,量少,好处是不出错。有人自动收集:找到什么就往机器里倒什么,剩下的听天由命。最鸡贼的是谷歌这种,让自家用户免费做标注。还记得 ReCaptcha 有时让你“选出照片里所有的交通标志”吗?干的就是这个。
好的数据集合(也就是数据集),大家都抢着要。大公司有时会公开算法,但极少公开数据集。
特征 我们管它叫 feature,不爱听英语外来词的朋友只好忍一忍了。叫 feature、属性、特点、特征都行:汽车的里程、用户的性别、股票的价格,甚至文本里某个词出现的频次,都可以是特征。
机器得知道具体要看什么。数据规规矩矩放在表格里就好办,每一列的列名就是一个特征。可要是手头有 100 GB 的猫片呢?特征一多,模型就跑得又慢又没效率。挑对特征花的工夫,往往比剩下的训练加起来还多。但也有反过来的情况:某个人形皮囊自作主张,只留自己眼里“正确”的特征。主观偏见进了模型,模型就开始满嘴跑火车。
算法 几乎任何一道题都不止一种解法。选哪种方法,决定了最终模型有多准、跑多快、个头多大。不过有个小前提:数据要是一坨屎,再好的算法也救不了。别光盯着那几个百分点,先去多收点数据。
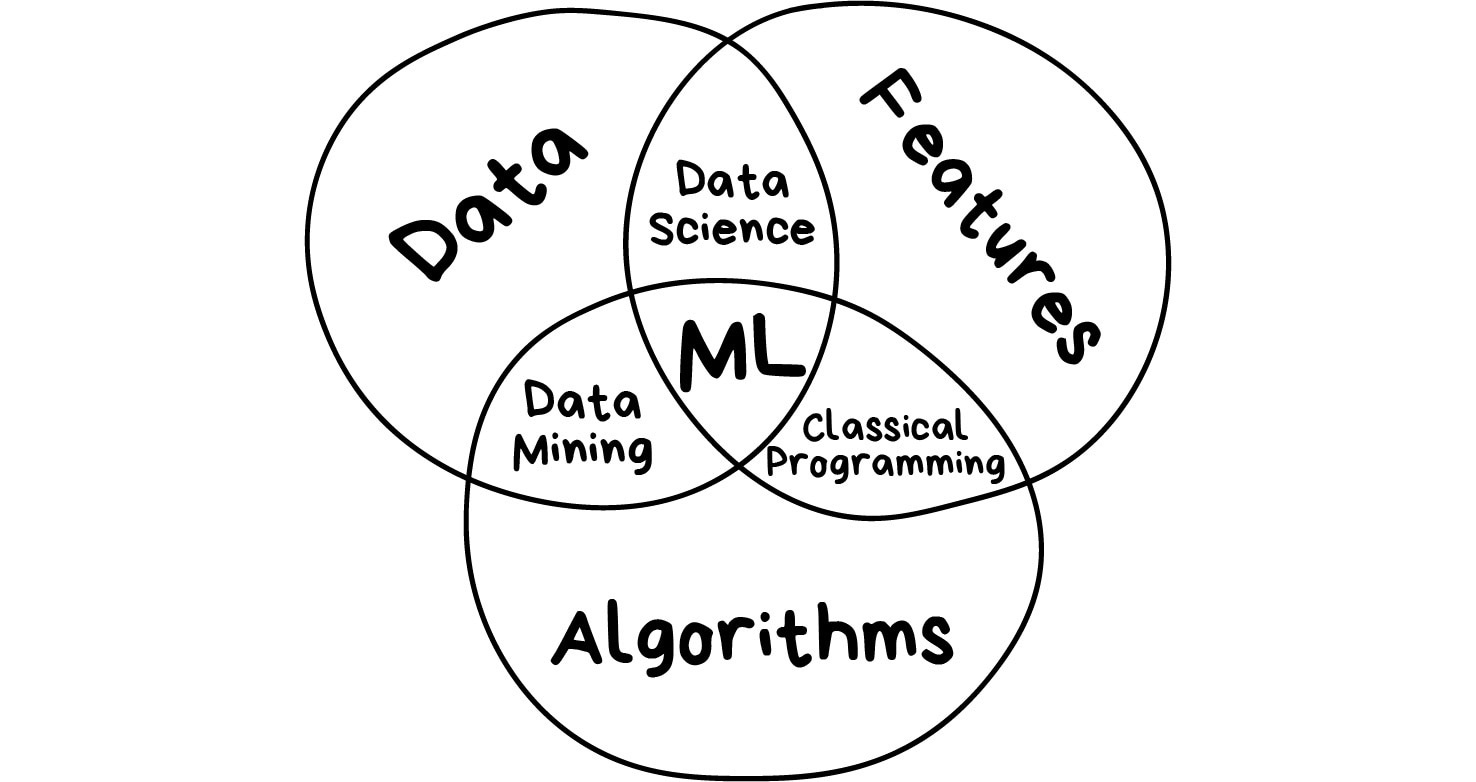
我在一家文艺青年爱看的媒体上见过这么个标题:《神经网络会取代机器学习吗?》 公关们写新闻稿,连楼下小孩都玩得转的线性回归,也敢叫“人工智能”。咱们看图,一次把区别讲清楚。
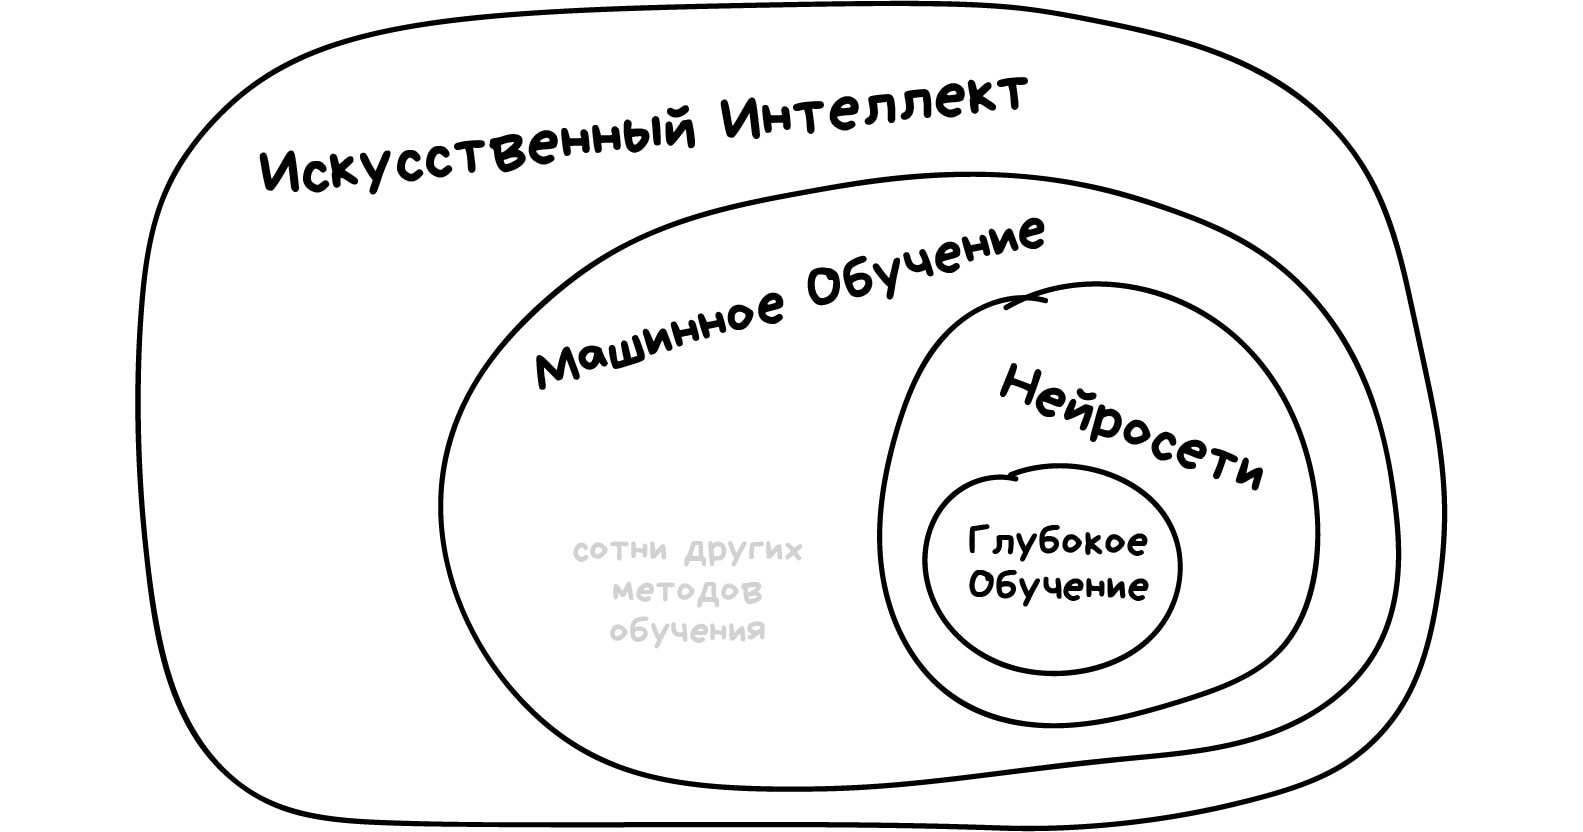
人工智能是整个领域的名字,就像生物学或化学。
机器学习是人工智能的一个分支。很重要,但不是唯一的分支。
神经网络是机器学习的一种。很流行,但别的方法也不差。
深度学习说的是神经网络的架构,是构建和训练网络的一种思路。今天真正干活的人,很少去区分哪个网络算深、哪个不太深。直接报具体网络的名字就完了。
要比就比同一层级的东西,不然问出来的就是“汽车和轮子哪个好”这种屁话。别没来由地把名词画上等号,显得自己像个傻瓜。
下面这些,有的是今天的机器会做的,有的就算训练得再好也办不到。
机器能 | 机器不能
--- | ---
预测 | 创造新东西
记住东西 | 一下子变聪明
复现 | 跳出任务范围
挑出最好的 | 干掉全人类
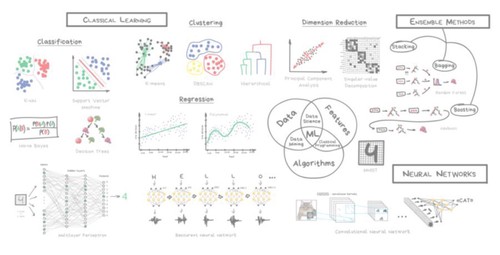
懒得读长文?至少盯着这张图看一会儿,不亏。
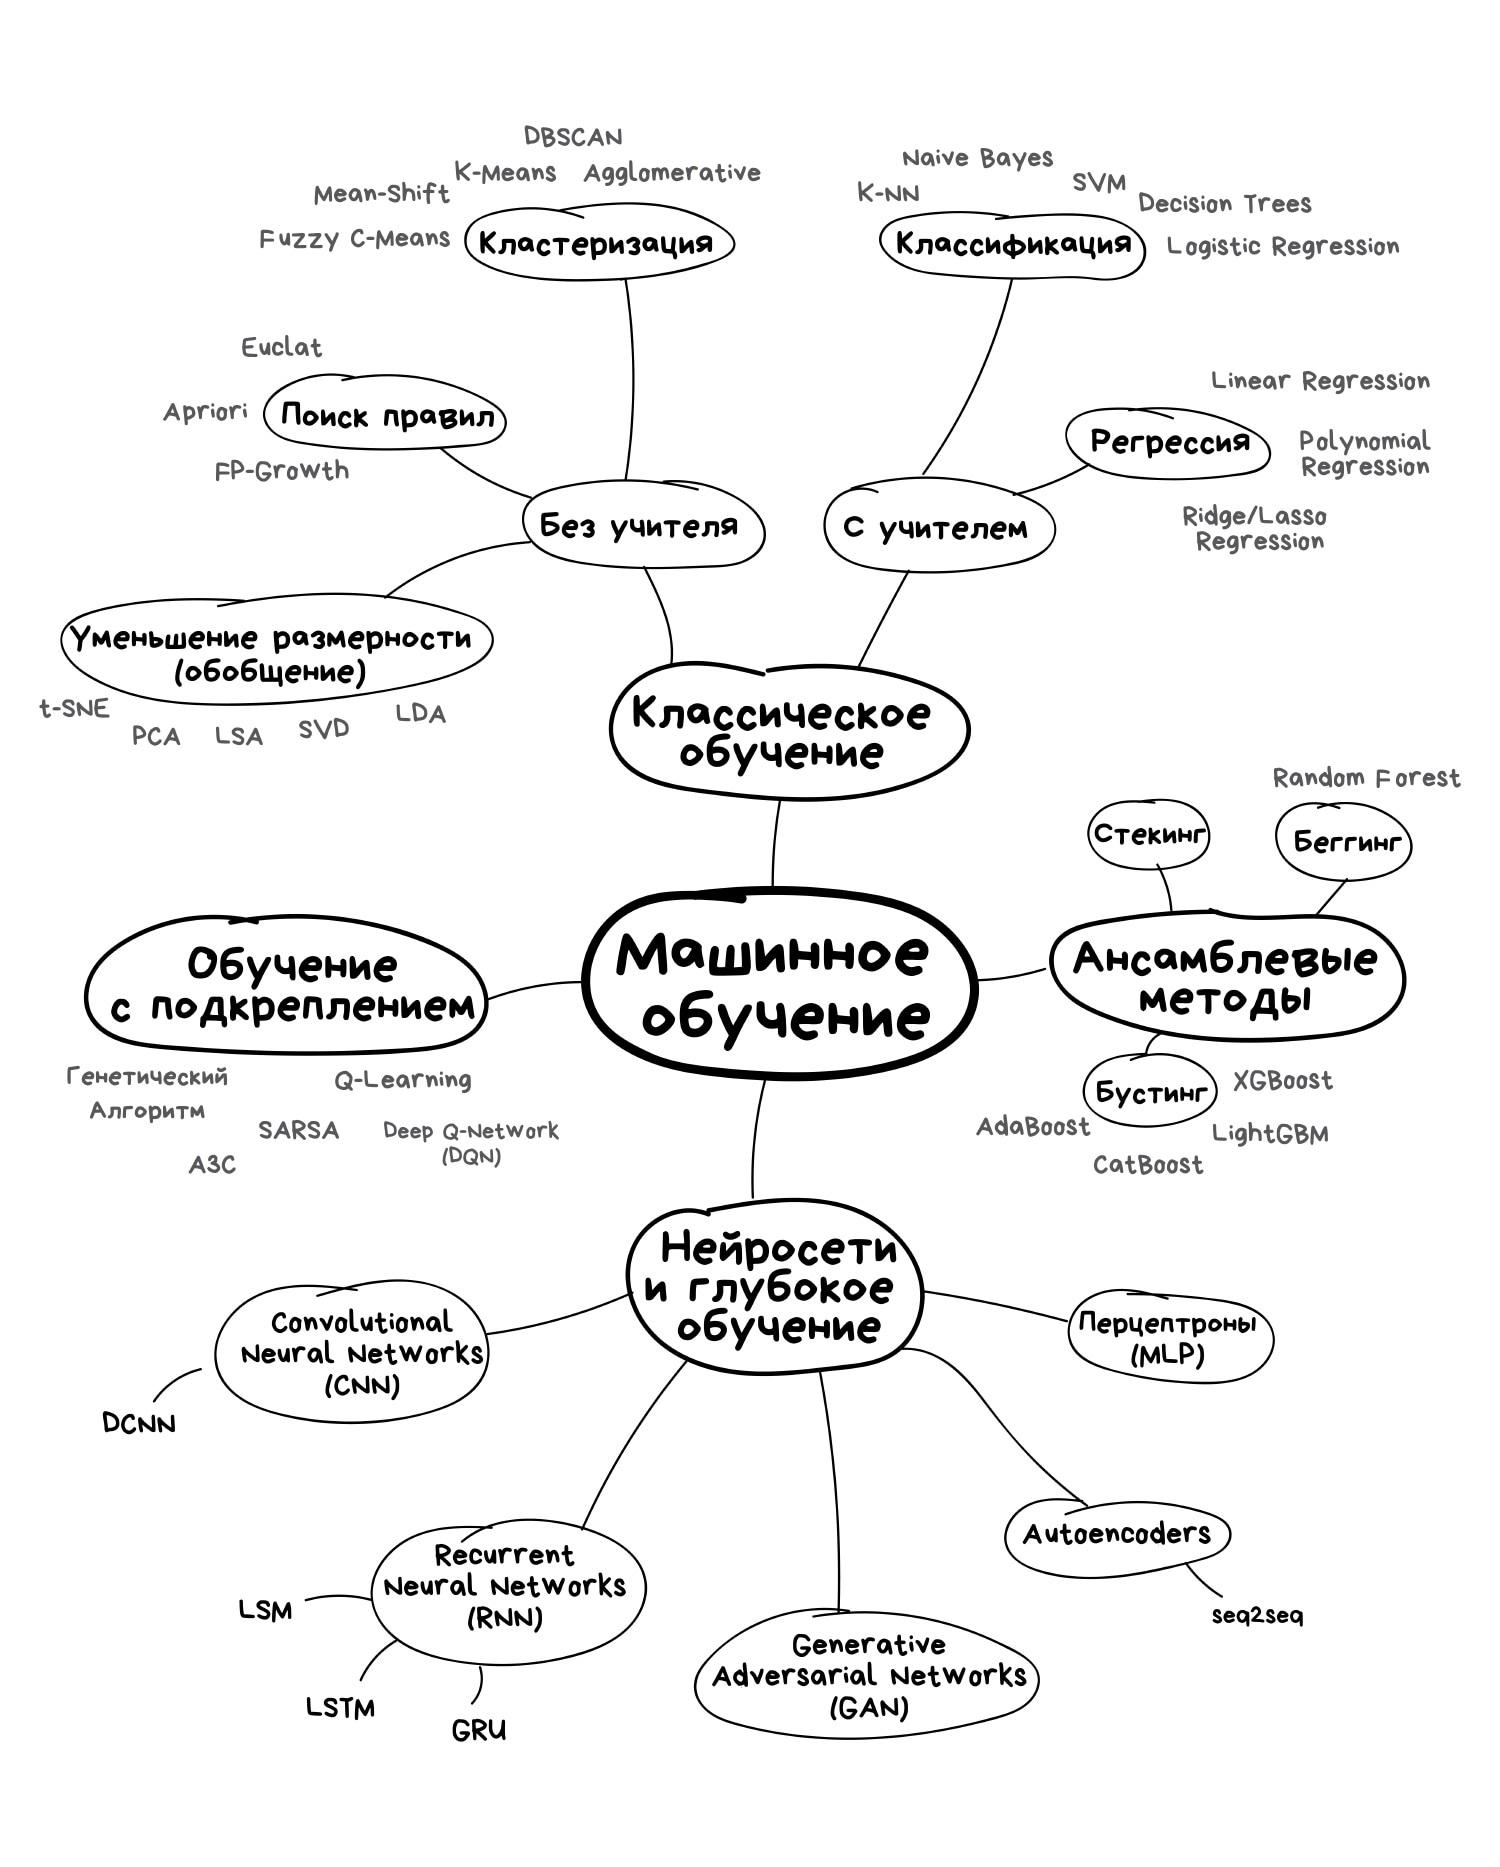
要是这篇大家喜欢,我打算回头画张正儿八经能挂墙上的地图,加上箭头,标清楚什么方法用在哪里。
哦,对了。算法能分出十来种不同的分法。我挑的这套,纯粹是因为讲起来最顺。别以为某个问题就只能用一种方法解决。下面我会举些有名的应用,不过别忘了,“别人家的孩子”拿神经网络就能把这些题全做了。
先看个大概。如今机器学习主要就四个方向。
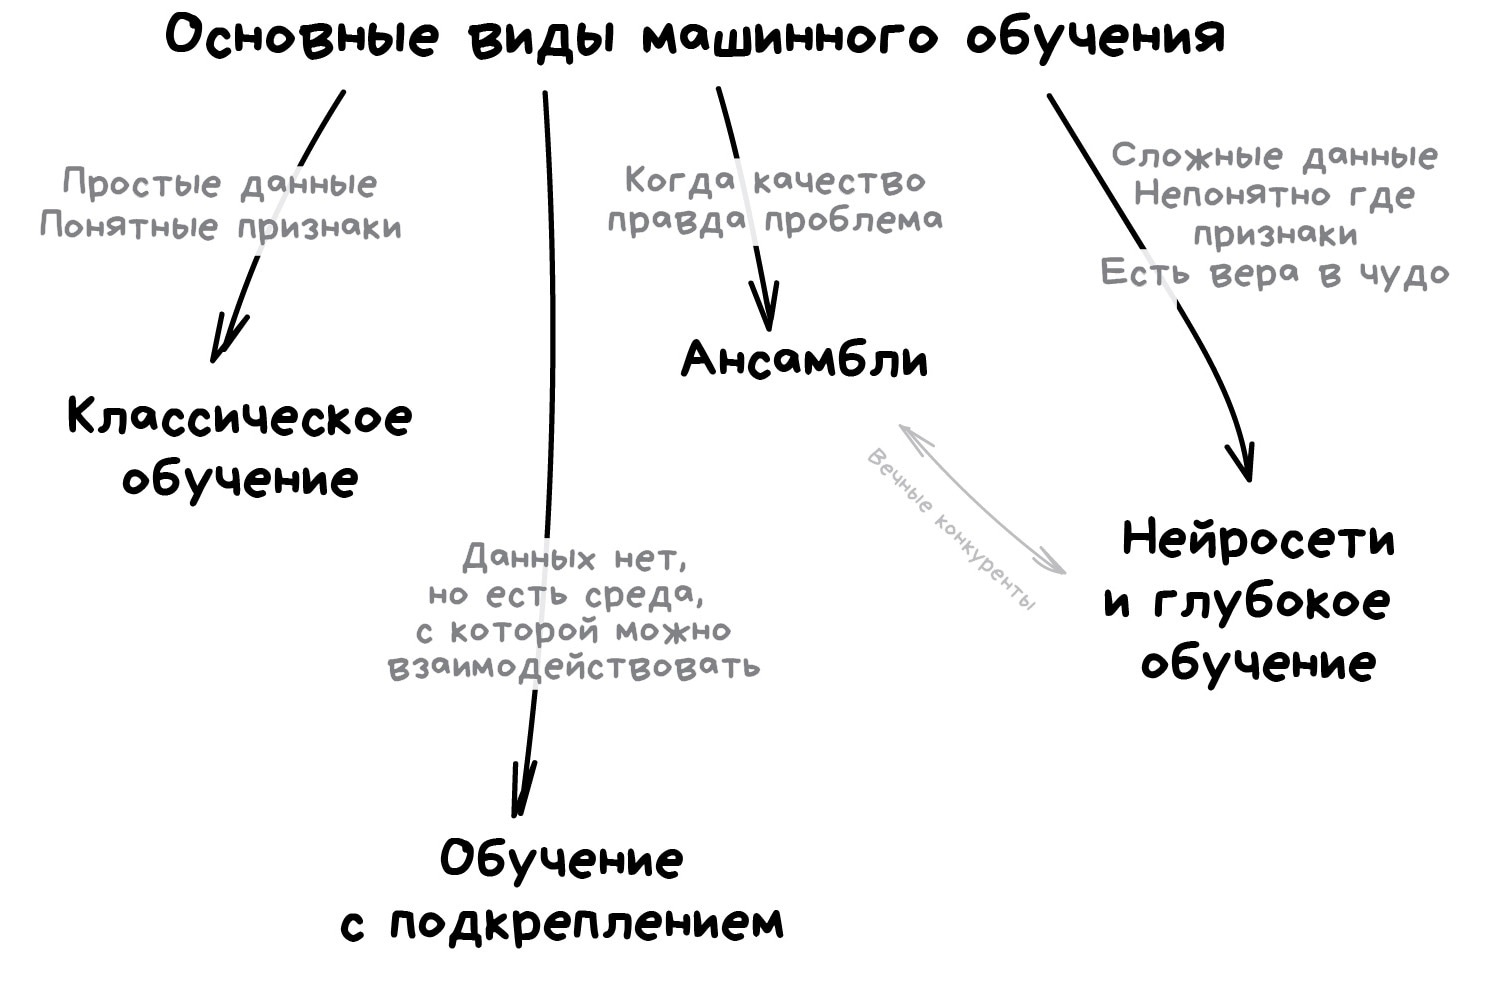
早在 20 世纪 50 年代,第一批算法就从纯统计学里走出来了。它们解决的是形式化的问题:在一串数字里找规律,判断空间里的点离得有多近,计算方向。
如今小半个互联网都得靠经典算法撑着。你在网站上看到“推荐文章”,或者刚出国买了第一杯咖啡,银行就把你卡里的钱全冻了——这几乎总是这些算法里某一位的手笔。
没错,大公司喜欢拿神经网络解决一切问题。因为准确率多 2%,对它们来说很容易就能变成多赚 20 亿。其他人还是得动动脑子。要是经典方法就能解决问题,先用它做个对业务多少有点用的系统,成本更低,之后再考虑怎么改进。要是问题压根儿就没解决,那把“没解决”做得再好 2%,也帮不上什么忙。
我知道好几个这样的笑话:团队花三个月,用更准的算法重写网店推荐系统,完工才发现顾客根本不用它。大多数人直接从搜索引擎点进来。
经典算法这么流行,道理却简单到连小孩都能听懂。今天它们就像基础算术,三天两头用得上,偏偏有些人还是开始忘了。
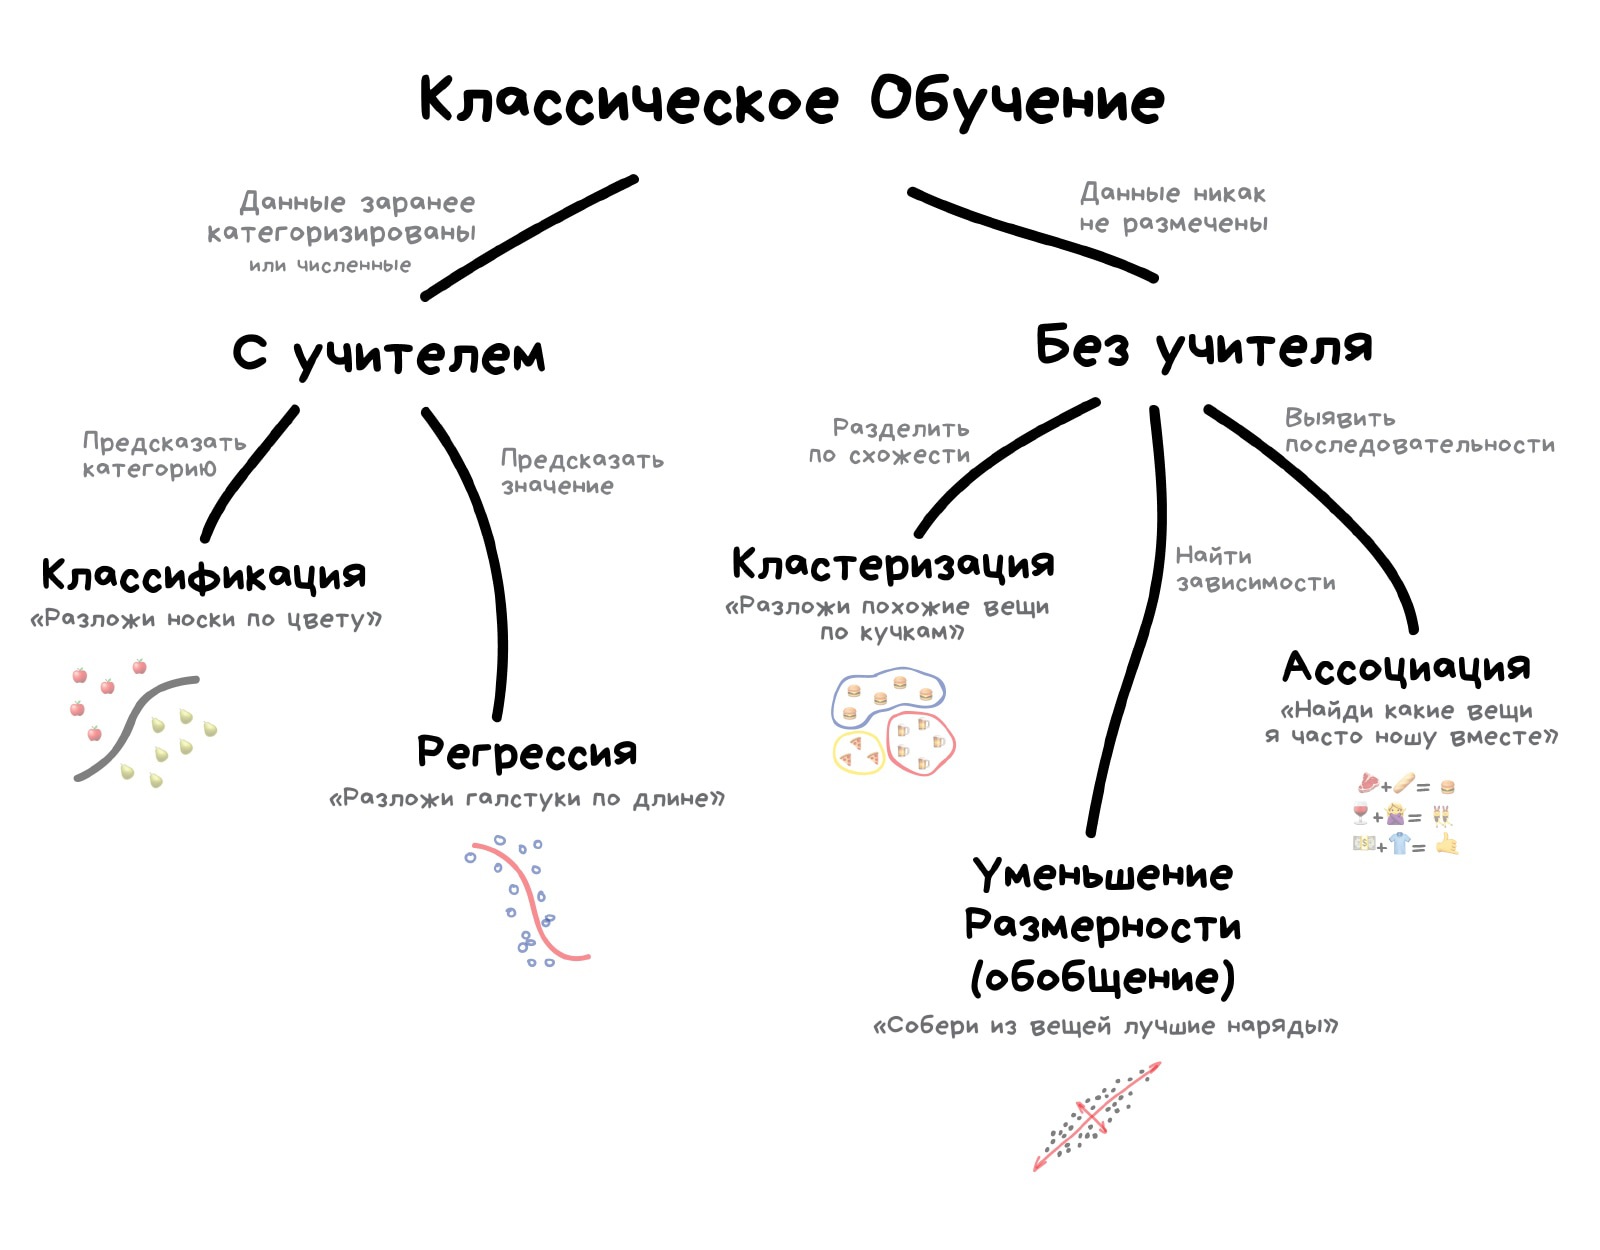
大家喜欢把经典机器学习分成两类:有老师的和没老师的。英文名你也常会碰到:Supervised Learning 和 Unsupervised Learning,也就是监督学习和无监督学习。
第一种情况下,机器有个老师,告诉它什么是正确答案:这张图里是猫,那张是狗。也就是说,老师已经事先把所有数据分成了猫和狗(做好了标注),机器跟着具体例子学就行。
无监督学习呢,就是把一堆动物照片往机器桌上一倒,说:“你自己瞧瞧,这里面谁跟谁像。”数据没标注,机器没老师,只能自己试着找规律。这些方法咱们下面再聊。
显然,有老师,机器就学得更快、更准,所以实际项目更多用监督学习。这些任务分两种:分类——预测对象属于哪个类别;回归——预测数轴上的位置。
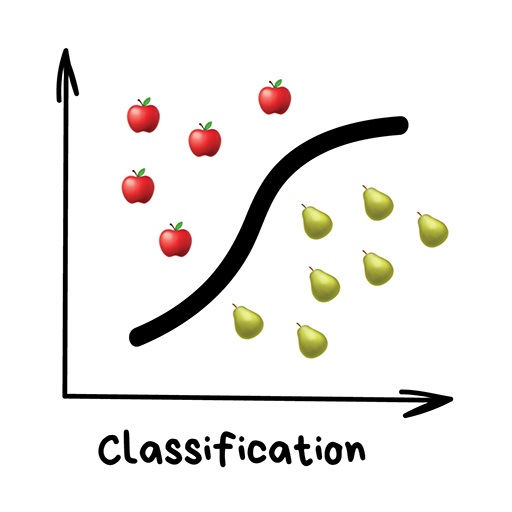
“根据事先知道的特征给东西分门别类。袜子按颜色分,文档按语言分,音乐按流派分。”
如今用来做这些事:
常用算法:朴素贝叶斯、决策树、逻辑回归、K 近邻、支持向量机
从这里往下,这些小栏都欢迎大家在评论里补充。说说你碰到的任务、应用领域和算法吧,我写的这些毕竟只是个人经验。
给东西分类,是整个机器学习里最常见的任务。机器就像学着收玩具的小孩:机器人放一个箱子,坦克放另一个。咦,那要是机器人坦克呢?好嘛,哇的一声哭出来,程序报错。
分类总得有个老师,也就是带标注的数据:既有特征,也有机器要学会根据特征认出来的类别。然后什么都能分:按兴趣分用户,算法推荐的信息流就这么干;按语言和主题分文章,这对搜索引擎很重要;按流派分音乐,想想 Spotify 和 Yandex 音乐的歌单。连你收件箱里的邮件也能分。
以前垃圾邮件过滤器用的都是朴素贝叶斯。机器数一数“伟哥”在垃圾邮件里出现多少次,在正常邮件里出现多少次。按贝叶斯公式把这两个概率一乘,把所有词的结果一加——砰!全体趴下,这是机器学习!
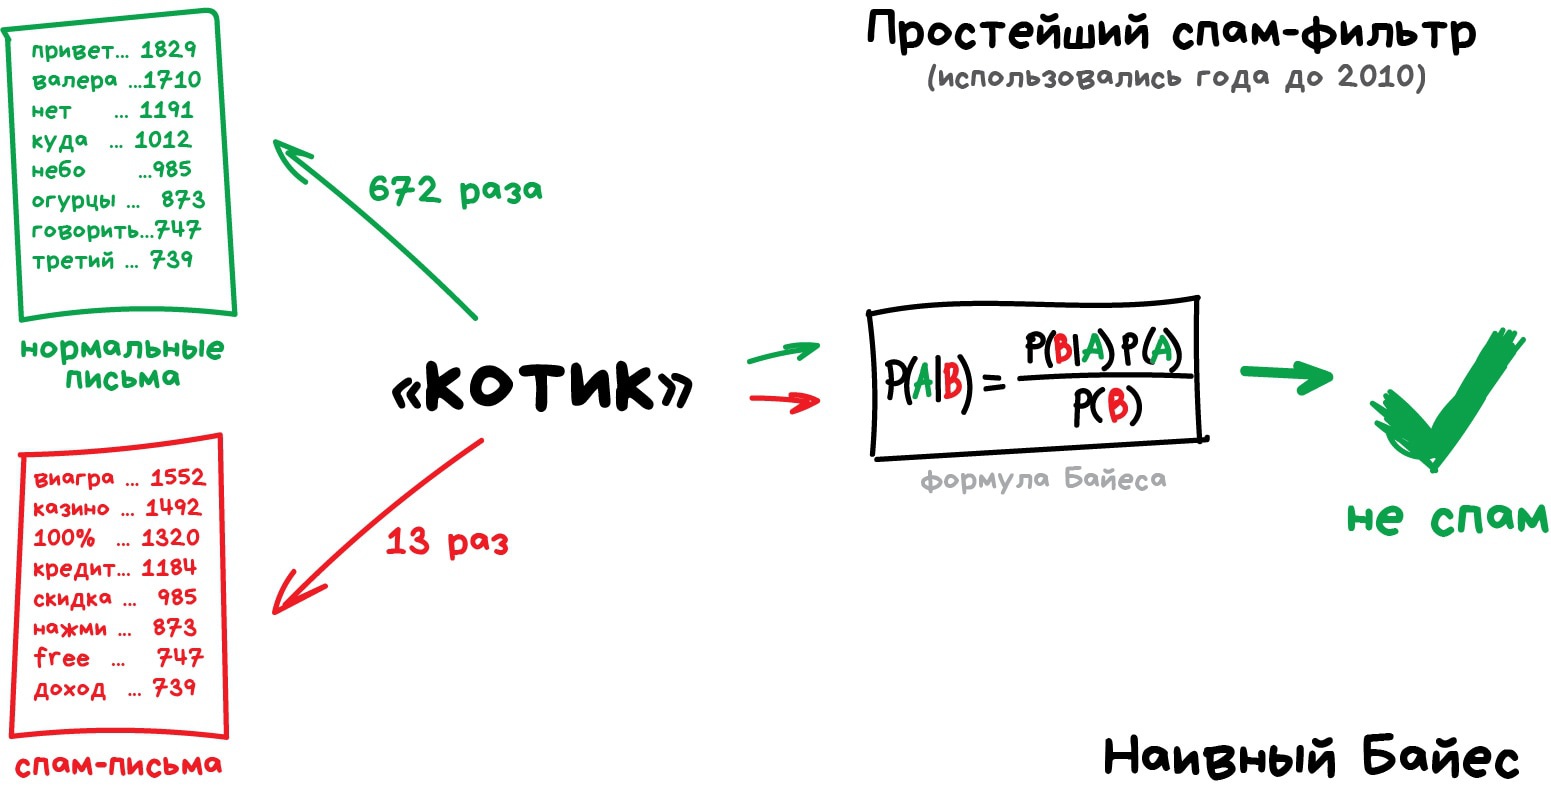
后来,发垃圾邮件的人学会了绕过贝叶斯过滤器:在邮件末尾塞上一大堆评分“良好”的词就行了。这招有个挺损的名字,叫贝叶斯投毒,过滤垃圾邮件也改用了别的算法。不过朴素贝叶斯在教科书里的位置算是坐稳了:既简单又漂亮,还是最早一批真能派上用场的方法之一。
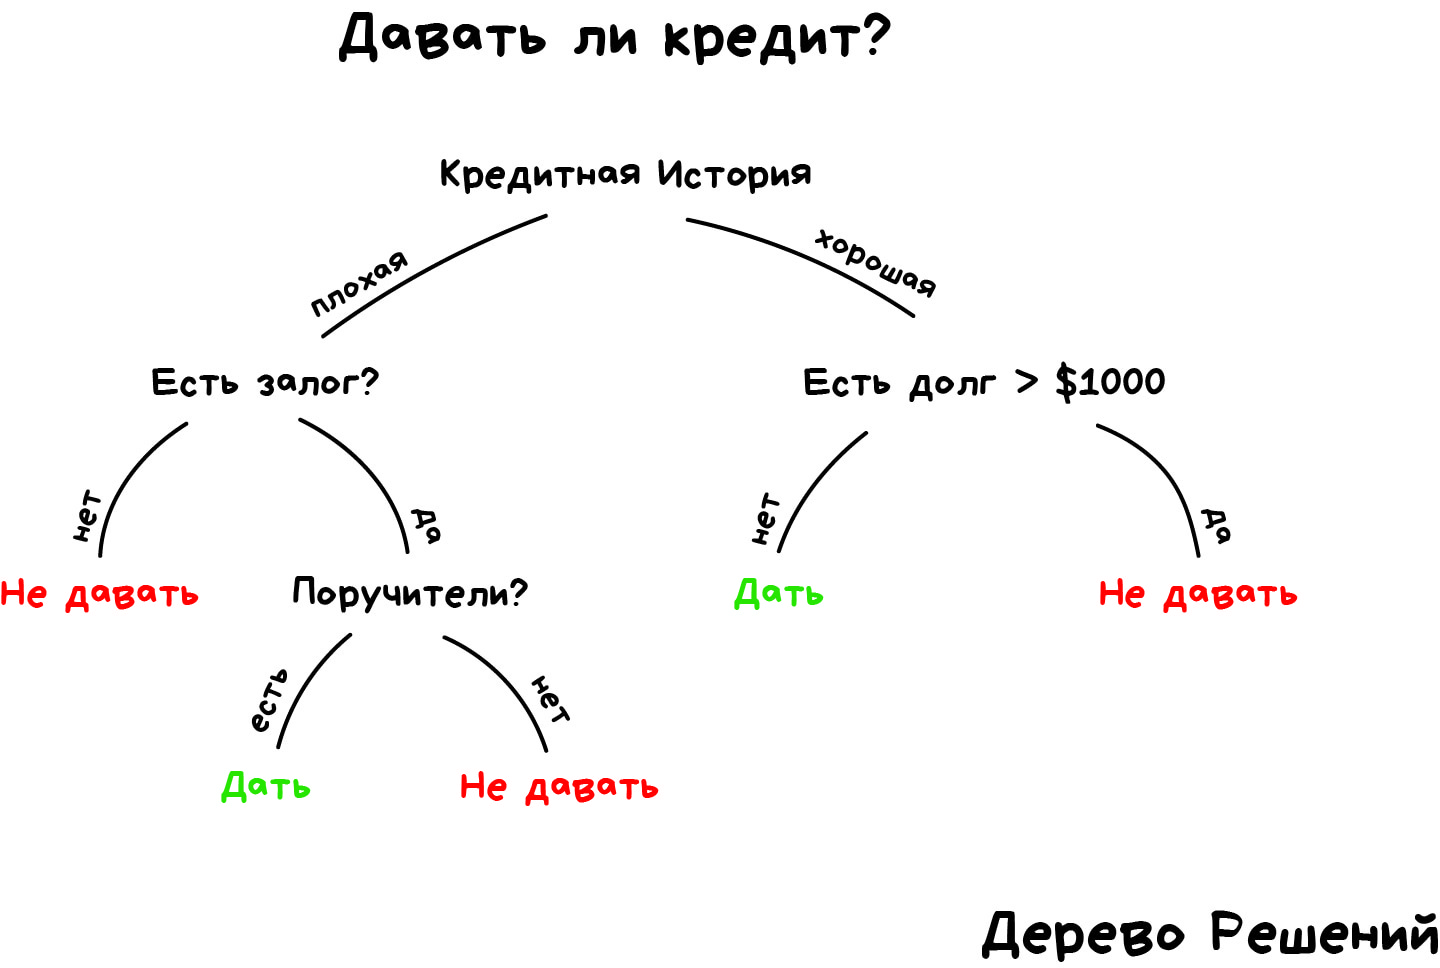
再举个分类派上用场的例子。你去银行贷款,银行怎么确定你会不会还?要说确定,那没办法。不过,银行手里有几千份在你之前贷过款的人的资料。上面有年龄、学历、职位、工资水平,还有最重要的一项:谁还了钱,谁的贷款出了问题。
对,大家都猜到了,哪些是数据,要预测的又是什么。训练机器、找规律、拿答案,这都不是问题。问题在于,机器不解释,银行不可能闭着眼睛信它。万一系统故障呢?有黑客使坏呢?或者管理员喝大了,决定顺手改个脚本呢?
为了解决这个问题,人们想出了决策树。机器自动提出一连串只用回答“是”或“否”的问题,把数据一批批分开。在人看来,这些问题不见得有多正常,比如“借款人的工资是否高于 25934 卢布?” 但机器这么问,是为了让每一步都分得尽可能准。
这些问题就长成了一棵树。越靠上,问题越笼统。之后甚至可以把问题扔给分析师,他们自会编出一套解释来。
决策树在出错要负大责任的领域找到了自己的位置:诊断、医疗、金融。
现在很少单用一棵树,但把树集成起来(后面会讲),就成了不少大型系统的根基,常常连神经网络都能打趴下。比如你上 Yandex 搜个问题,跑来替你给结果排序的,正是一群傻乎乎的树。
不过,论经典分类方法里谁最受欢迎,当之无愧的是支持向量机(SVM)。大家拿它分过的东西可多了:植物的种类、照片里的人脸、文档的主题,甚至还有奇奇怪怪的《花花公子》模特。好多年里,只要有人问“我该用哪个分类器”,首选答案都是它。
SVM 的思路其实很简单:在类别之间画两条直线,想办法让中间的空当尽可能宽。看图更直观:
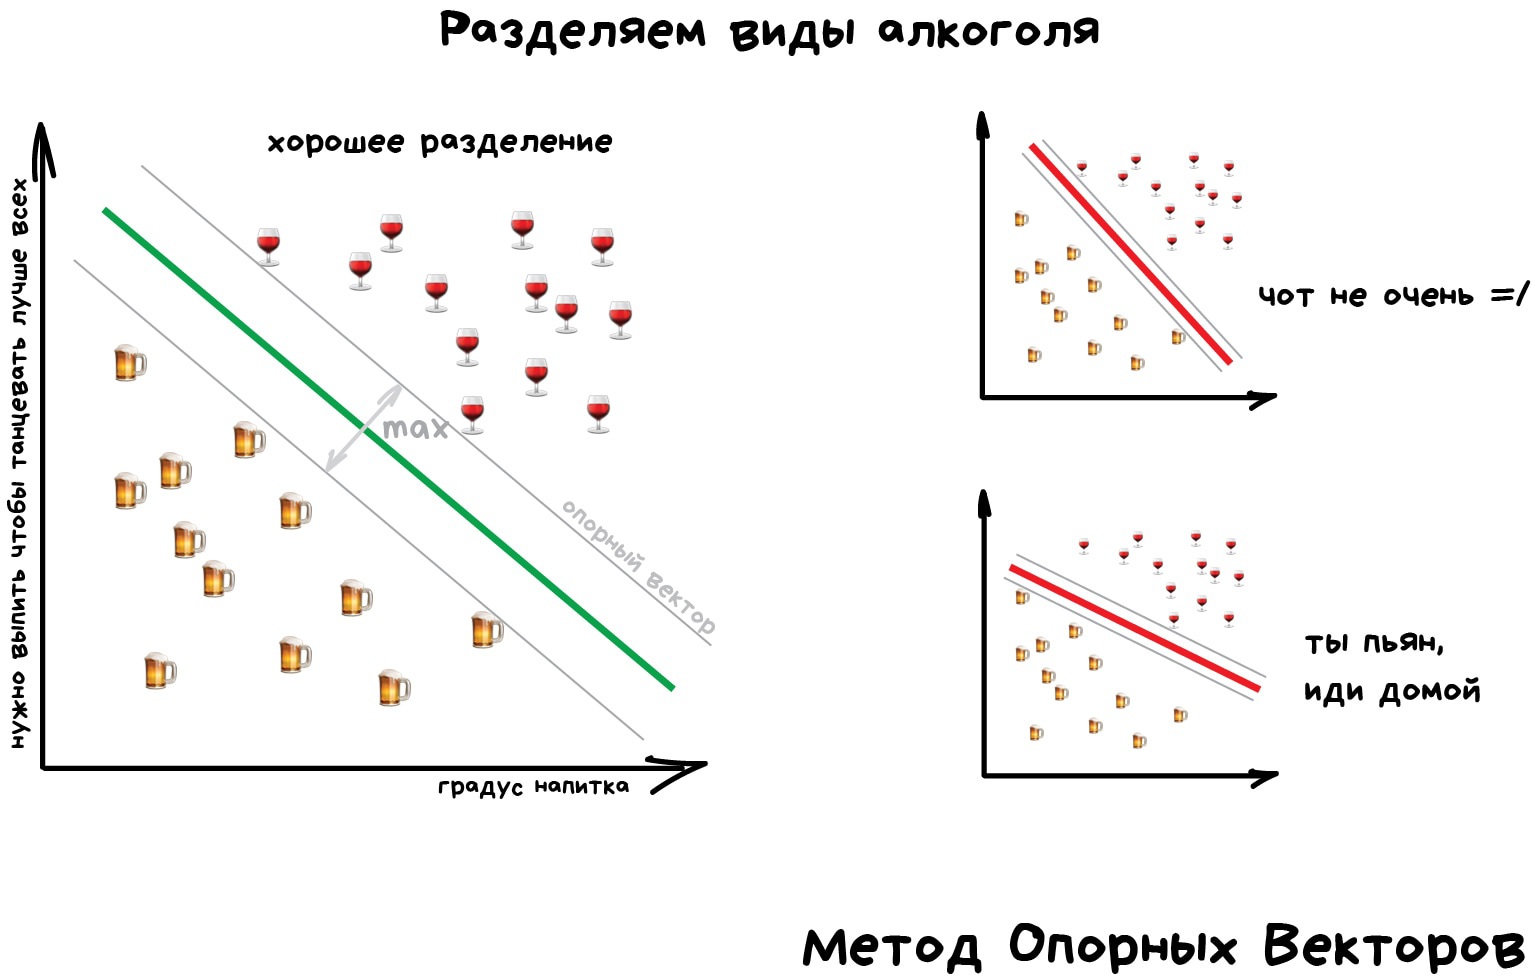
把分类反过来用,也能做件有用的事:找异常。某个对象的特征跟现有类别都格格不入,就在屏幕上把它亮出来。医学上已经在这么做:计算机把核磁共振图像上的可疑区域标给医生看,或是把化验结果里的异常值圈出来。交易所也用同样的办法找行为反常的交易者,他们很可能是知情人。教会计算机“怎样才对”,相当于顺手又得了个反向分类器:怎样不对。
如今人们越来越常拿神经网络做分类,说到底,它本来就是为这个发明的。
记个土办法:数据越复杂,算法也越复杂。 文本、数字、表格,我会先从经典方法试起。模型更小,训练更快,怎么工作的也更好懂。图片、视频,还有别的看不出门道的大数据,我就直接去看神经网络了。
五年前还能碰到用 SVM 做的人脸分类器,如今网上随便一翻就有上百个现成的网络,干嘛不用呢。倒是垃圾邮件过滤器,以前怎么拿 SVM 写,现在照样写,我看不出有什么非换不可的理由。
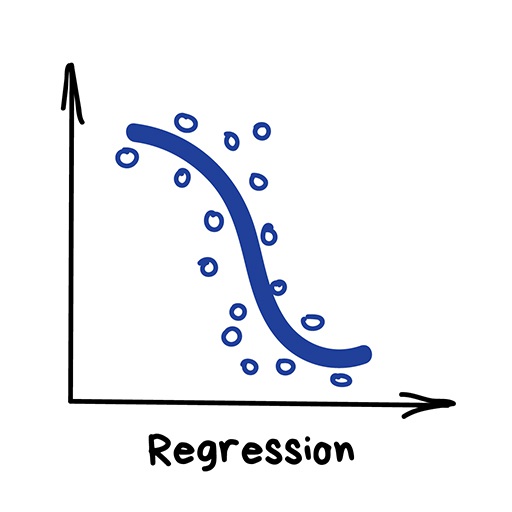
回归跟分类是一回事,只不过我们预测的不是类别,而是一个数。根据里程估算车价,根据一天中的时段估计会有多少地方堵车,根据公司的增长估计商品需求量,等等。但凡数值跟时间有关,都特别适合拿回归来做。
搞金融的和做分析的都很爱用回归,连 Excel 都内置了它。里面的道理还是很朴素:机器就是想画条线,大体反映出两者的关系。只不过跟拿着白板笔在白板上划拉的人不同,机器画起来有数学上的准头:算出到各个点的平均距离,争取谁都照顾到。
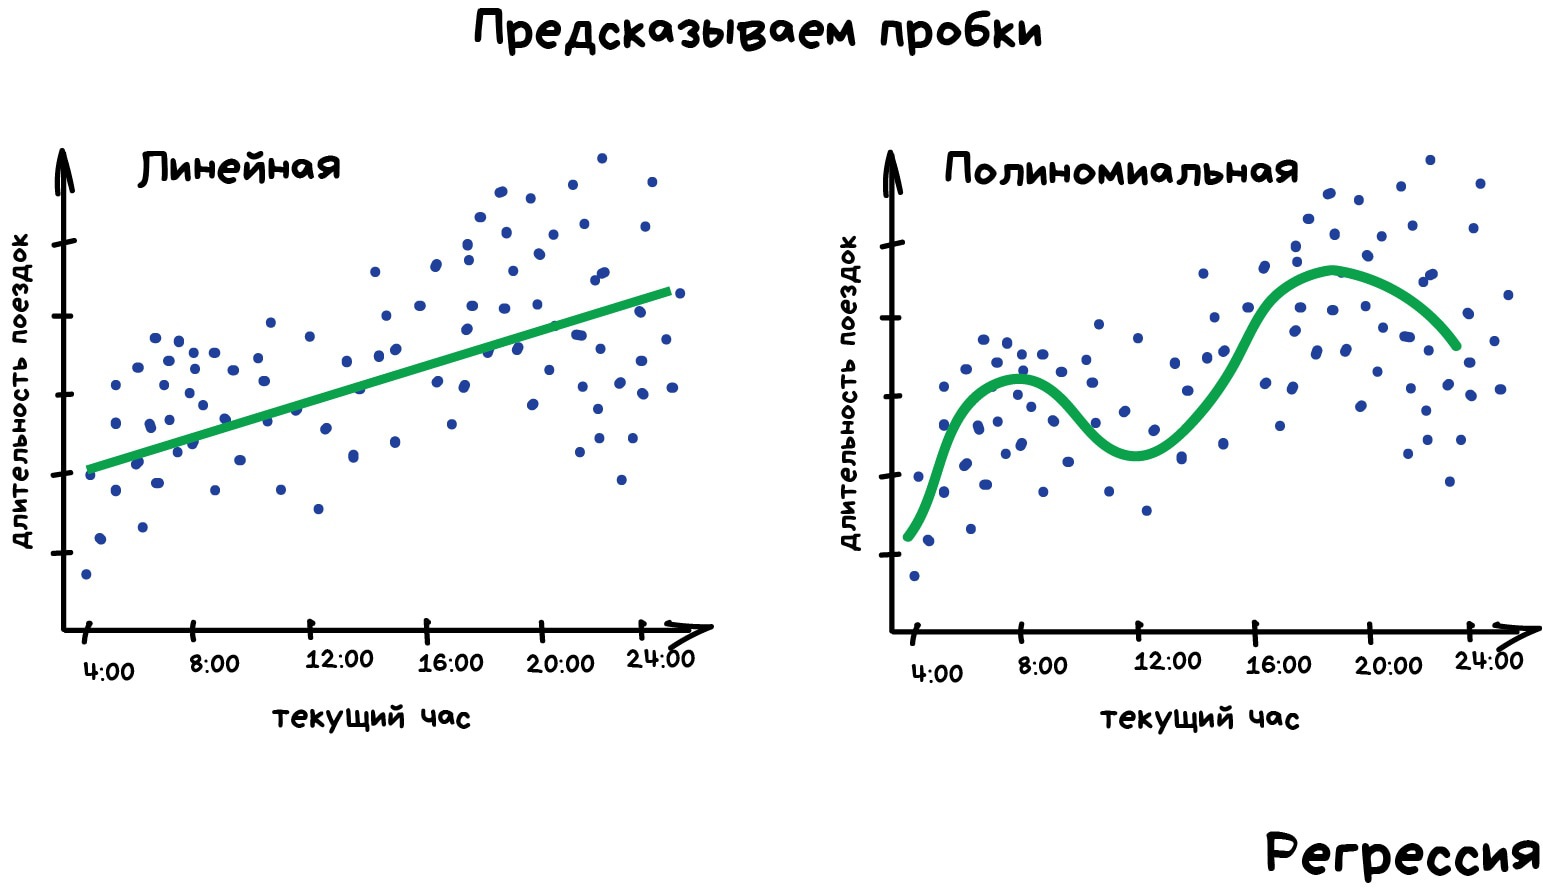
画出来是直线,叫线性回归;画出来是曲线,叫多项式回归。这是两种主要的回归,再往下就是稀有品种了。不过谁家还不出个怪胎:有个叫逻辑回归的,其实不是回归,而是分类方法,搞得大家老是弄混。起名别学它。
回归和分类有多像?很多分类器稍微调一调就成了回归器。比如不光看对象属于哪个类别,还记下它离那个类别有多近——这就有回归了。
想再深入点,又希望有人说人话,我推荐这个系列:写给普通人的机器学习(Machine Learning for Humans)
无监督学习(Unsupervised Learning)出现得更晚,要到 90 年代,实际用得也少些。但有的任务咱们还真没得选。
刚才说了,标好的数据又贵又少。可假设我想写个公交车分类器,怎么办?难道要我亲自上街,给一百万辆该死的伊卡鲁斯公交车拍照,再一辆辆标清楚是什么型号?一辈子就这么过去了,我 Steam 上的游戏还没通关呢。
没标注,还可以指望资本主义、贫富分层,以及 Yandex Toloka 这类平台上的一百万个中国人,五美分就肯帮你干什么都行。实际操作中,大家通常就是这么办的。不然你以为 Yandex 那些厉害的数据集是哪儿来的?
或者,你也可以试试无监督学习。说实话,我自己做过的项目里,还真想不起它在哪儿表现得特别好。
无监督学习用得更多的地方还是数据分析,而不是当主力算法。找个专门干这个、拿着莫斯科国立大学文凭的人形皮囊,往里倒一堆垃圾,盯着看。分出簇了吗?看出什么关系了吗?没有?那就接着干吧,劳动使人自由。不是你自己想干数据科学的吗?
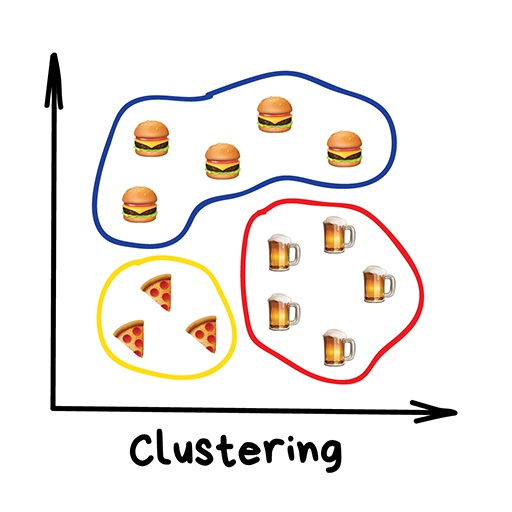
“按事先不知道的特征把东西分组。怎么分好,机器自己定。”
如今用来做这些事:
聚类就是分类,只不过事先不知道有哪些类别。算法自己找相似的对象,把它们归成一团,一团就是一个“簇”。要分几簇,可以事先定,也可以交给机器。机器按我们标出来的特征判断谁跟谁像:相似点多的,就往一类里放。
看网页地图上的标记就很好理解聚类了。你要搜莫斯科所有的精酿酒吧,地图引擎得把挨在一起的酒吧合成一个标着数字的小圆圈,不然浏览器光是试着画出一百万个标记就卡死了。
复杂一点的例子,想想 iPhoto 或 Google 相册:它们从照片中找出人脸,再按人归成相册。应用不知道你的朋友叫什么,却能凭各自的长相把他们区分开。典型的聚类。
当然,首先得找到这些能把人区分开的“面部特征”,这一步就非得有老师不可了。
图像压缩也是个常见问题。把一张图存成 PNG 的时候,你可以把调色板设成比如 32 色。聚类会找出图里所有“差不多算红色”的像素,给它们算个“大伙儿平均起来的红”,再拿它替换所有的红色。颜色少,文件就小。
问题是,碰到青色(Cyan)◼︎ 怎么办?你说它更接近绿还是蓝?这时候就轮到很常用的聚类算法 K 均值(K-Means)上场了。我们往调色板上随机撒 32 个点,管它们叫质心。把其余每个点都分给离它最近的质心,颜色相近的点就聚成了一小片星群。然后把质心挪到各自星群的中心,再来一遍,直到所有质心都不动为止。簇找到了,稳定了,不多不少,正好是我们要的 32 个。
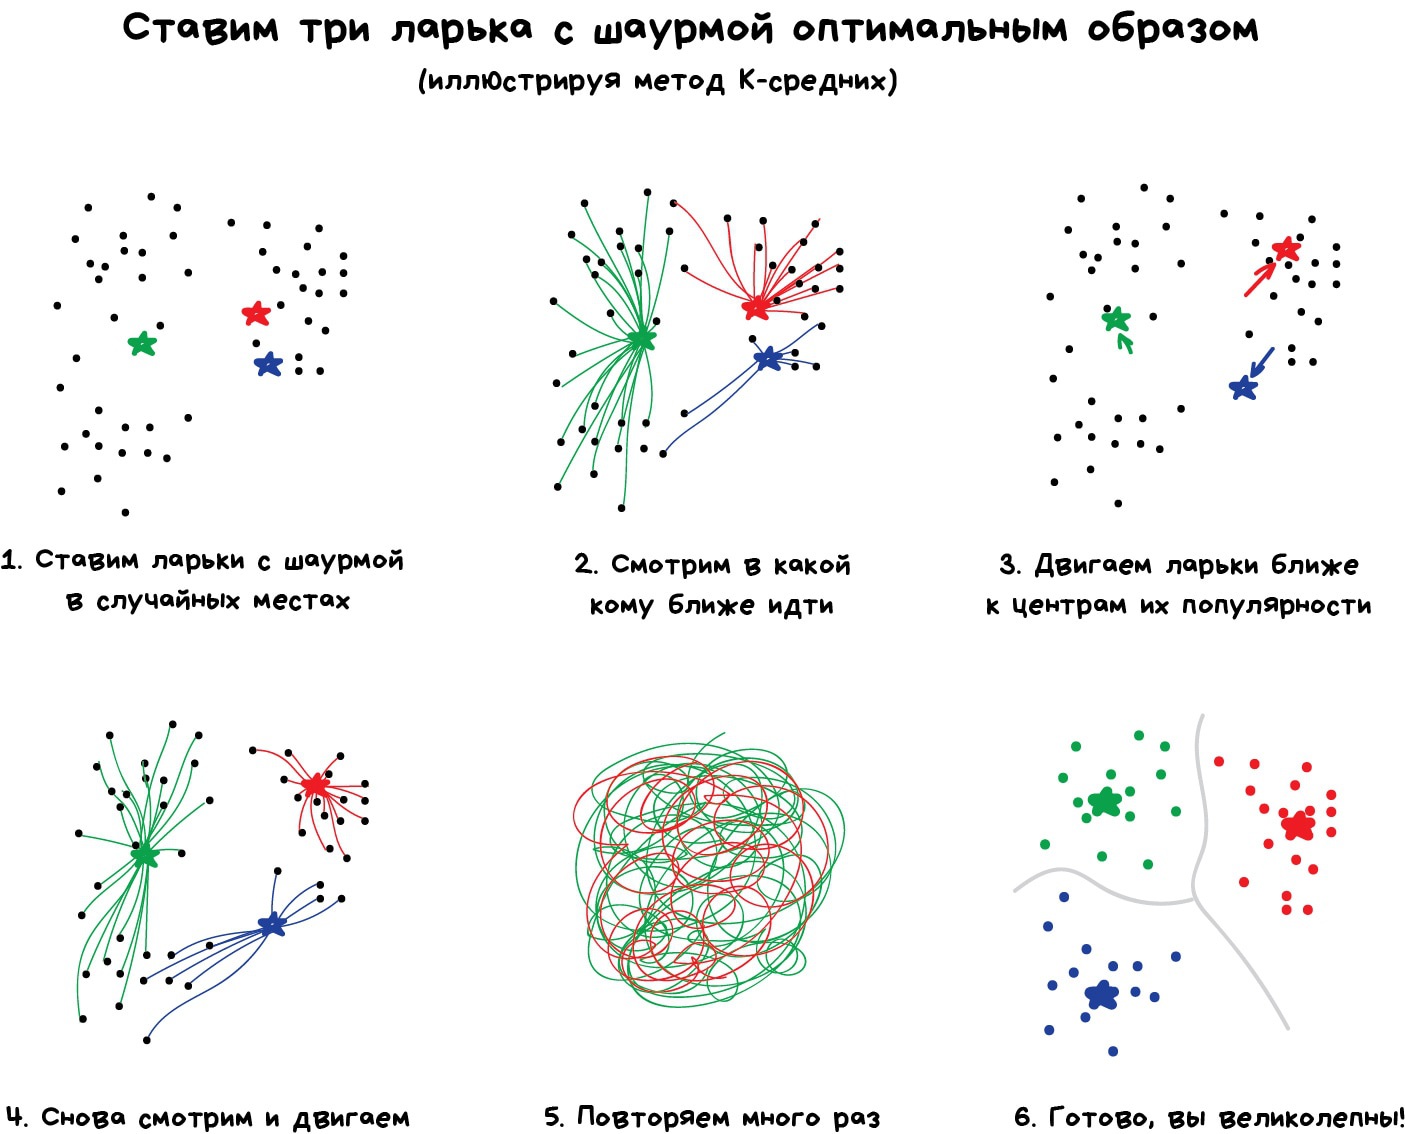
找质心简单方便,可现实里的簇未必都是圆的。假设你是地质学家,要在地图上找结构相似的岩石:这些簇不光会一层套一层,你还压根不知道最后会分出几个。
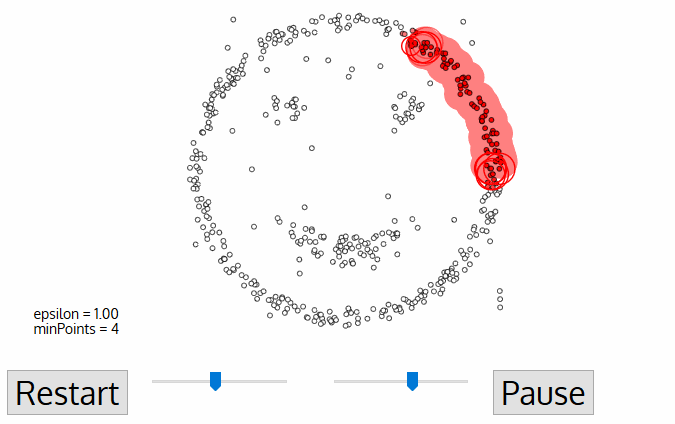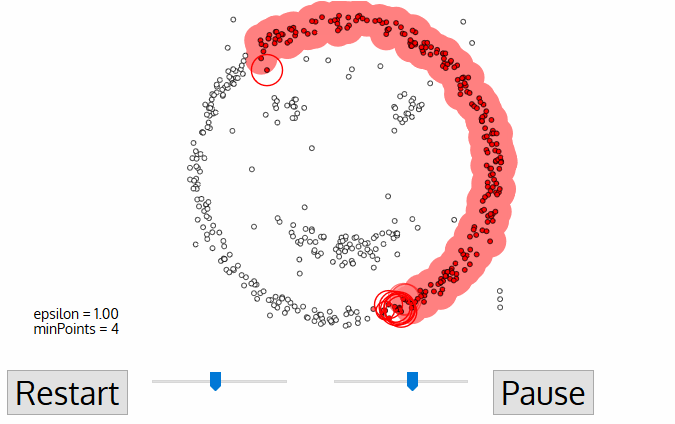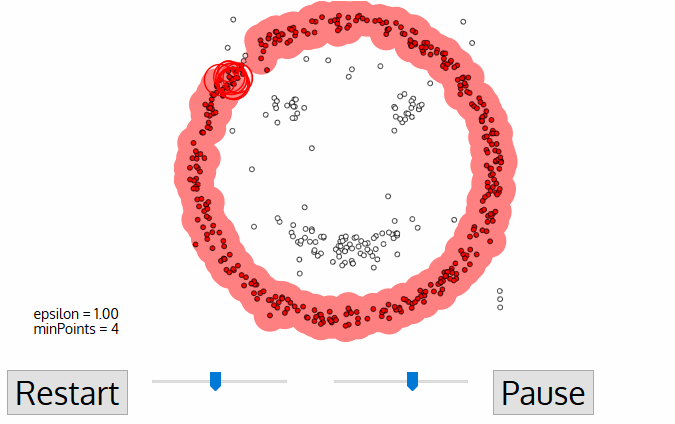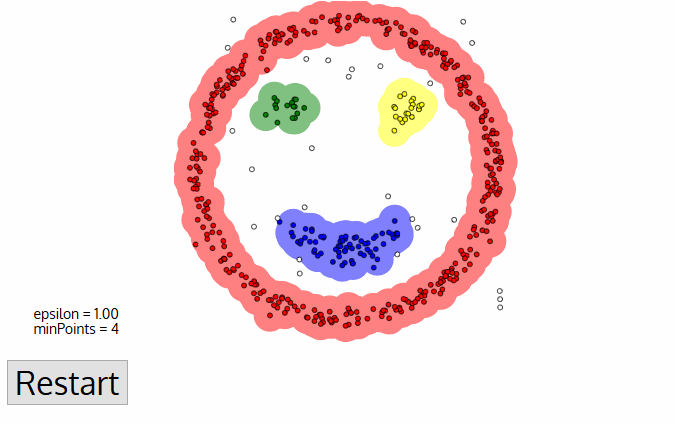
刁钻的问题得用巧一点的办法,比如 DBSCAN。它自己找扎堆的点,围着它们划出簇来。把点想成广场上的人就很好懂了。随便找三个站得近的人,让他们手拉手。接着让他们去拉够得着的人的手。就这么一个拉一个,直到再也拉不到新人,这就是第一个簇。重复这个过程,直到所有人都分好了。那些谁的手都够不着的人,就是离群点,也就是异常。动起来还挺好看:
对聚类有兴趣的话,我推荐这篇《数据科学家需要知道的五种聚类算法》
跟分类一样,聚类也能用来检测异常。某个用户注册后的行为跟正常人差得太远?先封掉,给客服开张工单,查查是不是机器人。我们甚至不必知道什么叫“正常行为”,只管把所有用户的操作倒进模型,让机器自己琢磨谁才算正常。
跟分类比起来,这招的效果不怎么样。不过试试又不挨打,万一成了呢。
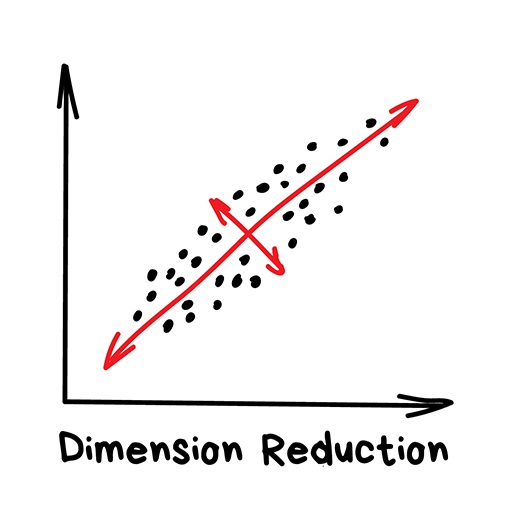
“把具体特征合成更高层次的抽象概念。”
如今用来做这些事:
常用算法:主成分分析(PCA)、奇异值分解(SVD)、隐含狄利克雷分配(LDA)、潜在语义分析(LSA、pLSA、GLSA)、t-SNE(用于可视化)
最早用这些方法的是一帮硬核数据科学家:有人卸下两卡车数字,叫他们从里头找点有意思的东西。等到拿 Excel 画几张图已经不顶用了,他们就想出让机器替自己找规律的办法。这才有了所谓的降维(Dimension Reduction),或者说特征学习(Feature Learning)。
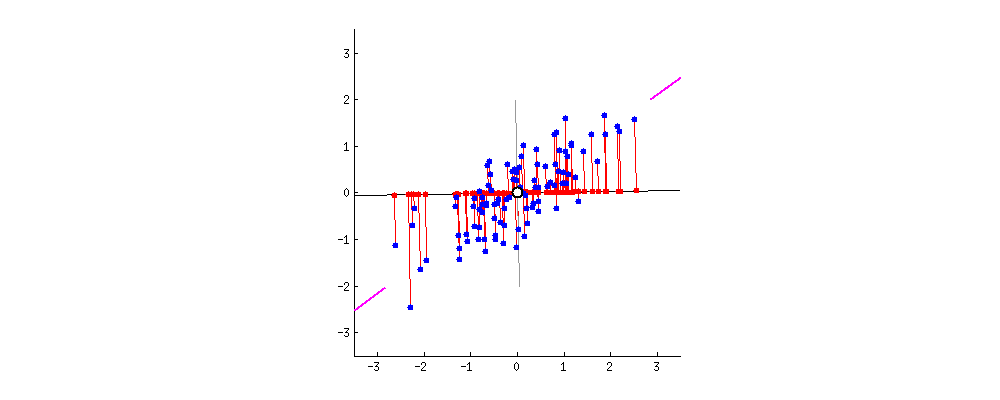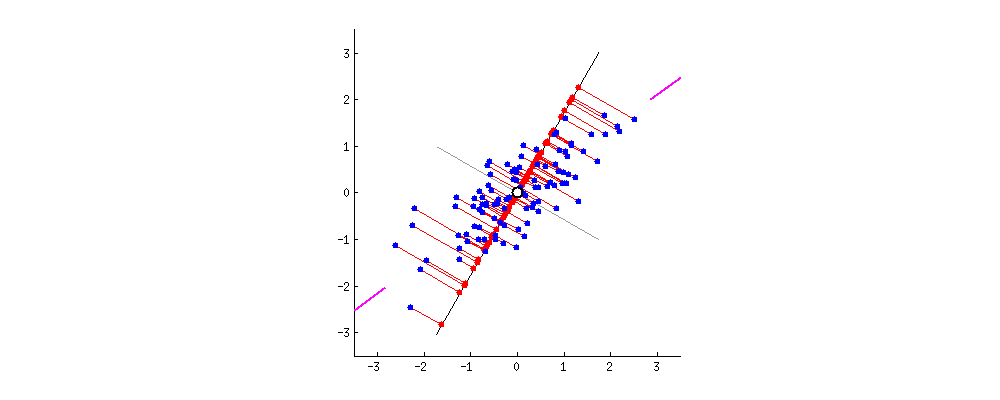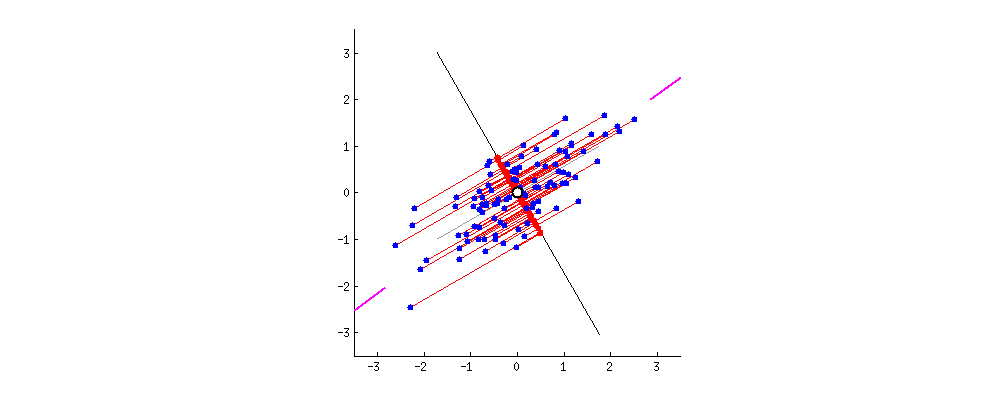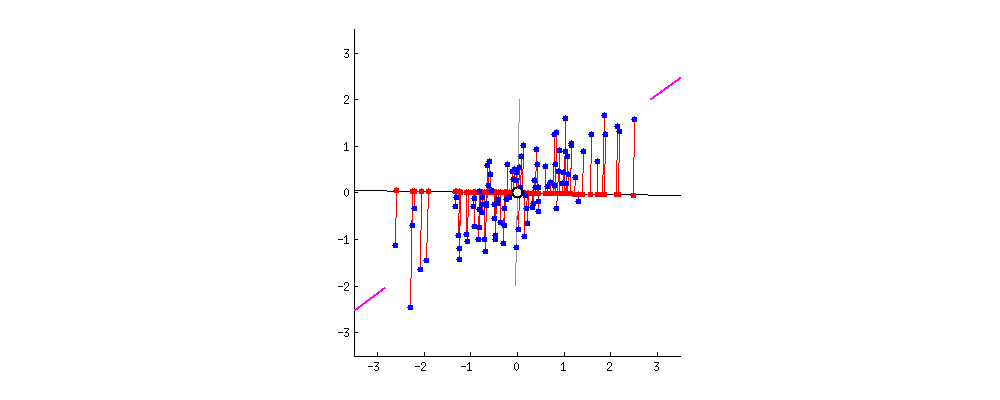
这对我们有什么实际用处呢?可以把好几个特征合成一个,得到一个抽象概念。比如三角耳朵、长鼻子、大尾巴的狗,可以概括成一个很有用的词:“牧羊犬”。没错,每一只牧羊犬的具体信息会损失一些,但这个新概念比那些多余的细节好用多了。而且维度少了,训练起来也快得多。
这工具拿来给文本找主题(Topic Modelling),居然好用得很。我们可以从具体的词上升到意思这一层,连拿着类别清单的老师都不用请。这个算法叫潜在语义分析(LSA),思路是:一个词在文本里出现的频率,跟文本的主题有关。科学文章里技术术语多,政治新闻里政客的名字多。当然,我们也可以拿出文章里的所有词,像刚才给街边小店分组那样做聚类,但这样会丢掉词与词之间很有用的联系。比如不同文档里用的电池和蓄电池,说的是同一个东西。
那样做出来的系统,准确率烂到家了。别试了。
得想办法把词和文档合成一个特征,才不至于丢掉这些隐藏着的(潜在的)联系。这个方法的名字就是这么来的。结果发现,奇异值分解(SVD)很轻松就能搞定:从经常一起出现的词里,找出对我们有用的主题簇。
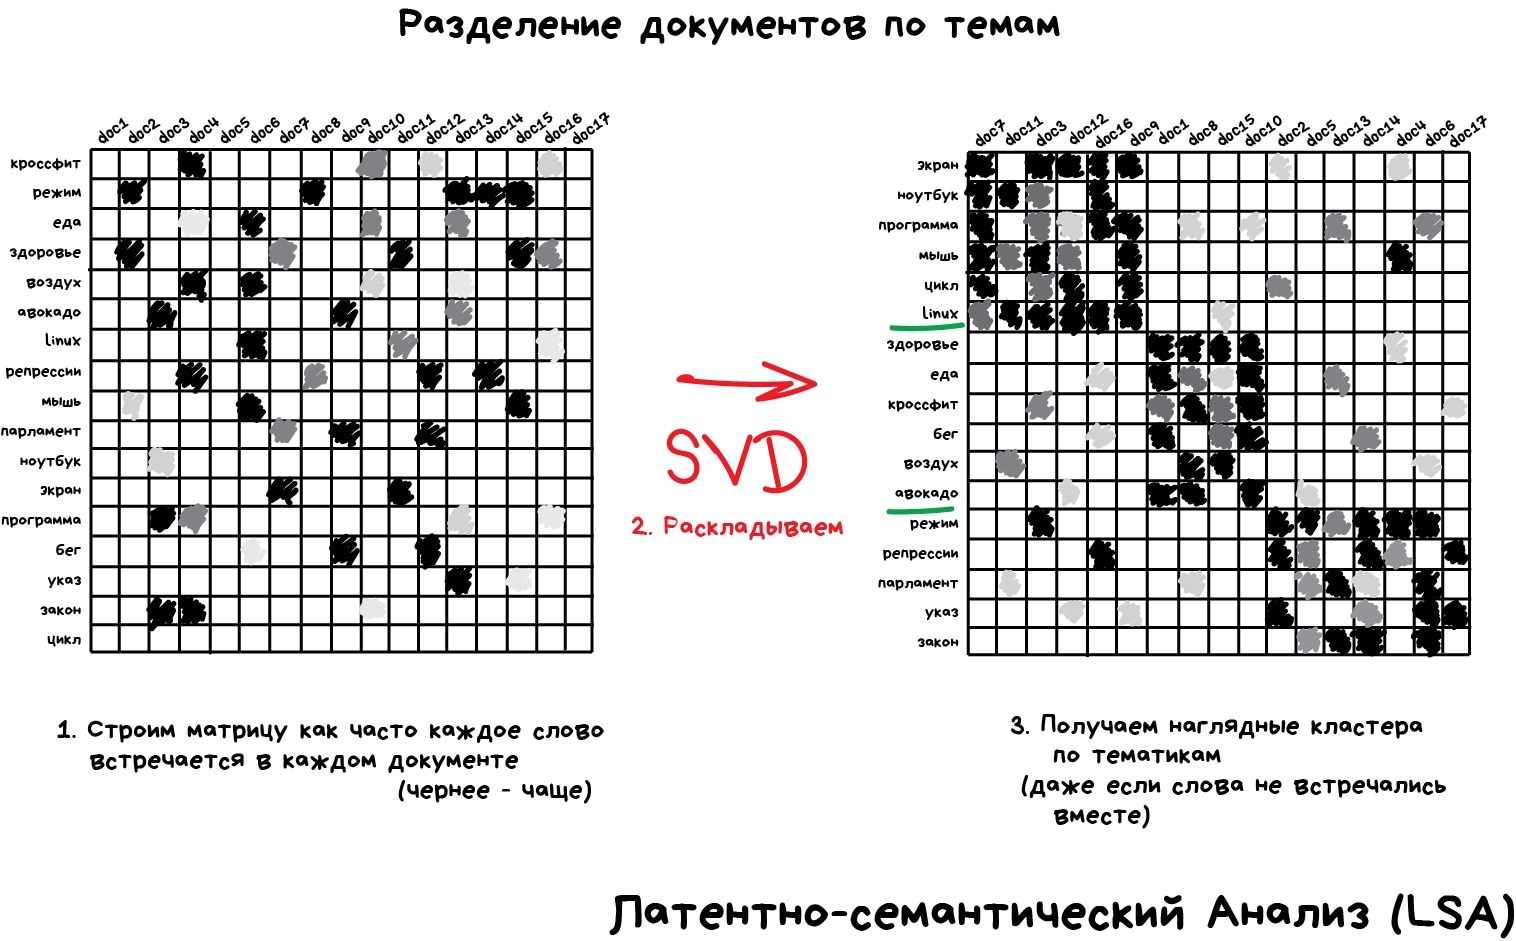
想弄懂原理,我推荐《怎样减少维度,并让它派上用场》;实际怎么用,《用 LSA 算法搜索相似文档》讲得不错。
降维还有个极其流行的用途:推荐系统和协同过滤(我写过介绍它们有哪些类型的文章)。原来,拿它把用户给电影打的分抽象一下,就能做出挺不错的推荐系统。电影、音乐、游戏,想推荐什么都行。
得出的抽象概念,人脑不大看得懂。不过研究人员仔细打量这些新特征,发现有些明显跟用户年龄相关(小孩更常玩《我的世界》、看动画片),有些跟特定电影类型相关,还有些居然跟“看什么都非得挖出点深意”这种毛病相关。
机器除了用户评分一无所知,居然摸到了这么高深的东西,尽管自己一点也不懂。佩服。接下来就可以做社会调查、写毕业论文了:为什么大胡子老爷们喜欢看弱智动画片?
讲这个话题,Yandex 有堂不错的课:推荐系统是怎么工作的
“从一笔接一笔的订单里找规律。”
如今用来做这些事:
分析购物篮、营销策略以及其他各种序列的方法,都归在这里。
假设顾客从商店最里面的角落拿了啤酒,正往收银台走。该不该在他路上摆点坚果?大家常把这两样一起买吗?啤酒配坚果,大概是吧。那还有哪些东西人们会一起买?如果你开的是连锁大卖场,答案未必那么显而易见,但只要在商品摆放上稍微动点脑筋,就可能多赚不少钱。
网店也一样,只不过问题还更有意思:这位顾客下次回来,会买什么?
不知道为什么,在所有机器学习方法里,我觉得关联规则这块儿琢磨得最烂。经典做法就是用树或者集合,把买过的商品两两配对,挨个穷举。算法本身只干了半截活儿:会找规律,却不会概括,也不会把规律用到新例子上。
现实里,每家大零售商都在自己造轮子,我还没见过这个领域有什么特别的突破。最有技术含量的,大概就是做个上一节说的那种推荐系统。当然,也可能是我跟这行隔得太远。懂行的来评论里聊聊?
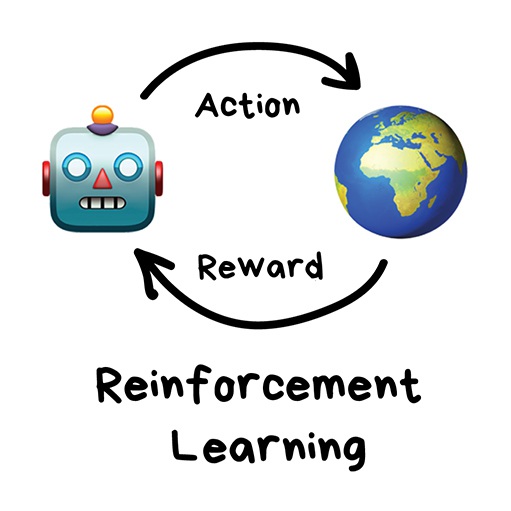
终于讲到看起来有点像真正的人工智能的东西了。不知为何,好多作者把强化学习放在监督学习和无监督学习之间。我一直没搞懂它们哪儿像。名字吗?
用强化学习的场合,任务不是分析数据,而是在实际环境里活下来。
环境甚至可以是个电子游戏。早在五年前,会玩《马里奥》的机器人就很火了。环境也可以是现实世界。比如特斯拉的自动驾驶系统,它得学会不撞行人;再比如扫地机器人,它的首要任务是以最高效率把你家猫吓出屎来。
了解周围的世界对这样的机器人有用,不过只供参考。收集再多数据,也不可能预见所有情况。所以它的目标是尽量少犯错,而不是算尽每一步。机器人学的是怎样在环境里活得最划算:衡量标准可以是马里奥捡了多少金币,特斯拉跑这一趟花了多少时间,或者干掉了多少人形皮囊,嘿嘿嘿。
学会在环境里生存,就是强化学习的思路。把可怜的机器人扔进现实生活,做错了罚,做对了奖。在人身上用着挺灵,干嘛不拿机器人试试。
聪明一点的扫地机器人和自动驾驶汽车就是这么训练的:给它们造一座虚拟城市(经常照着真实城市的地图造),随机放些行人进去,派它们去学怎么不撞死人。等机器人在这套人造《GTA》里混得挺自在了,再放它上真街道测试。
机器不用记住城市本身,这种做法叫 Model-Free(无模型)。当然,也有经典的 Model-Based(基于模型)做法,可那样一来,我们的车就得记住整颗行星的模型,记住世界上每个路口可能发生的每一种情况。这根本行不通。在强化学习里,机器不是背下每一个动作,而是试着归纳碰到的情形,好让自己每次都能捞到最大的好处。
还记得几年前那条机器下围棋赢了人类的新闻吗?就在那之前不久,才有人证明,围棋的局面从物理上就不可能全算完,因为数量比宇宙中的原子还多。也就是说,下国际象棋时,机器确实靠算完后续所有可能性赢了棋,围棋可不吃这一套。于是它只管从每种局面里挑出最好的一步,挑得足够准,就赢了对面那个有皮有肉的混蛋。
这就是 Q 学习及其衍生算法(SARSA 和 DQN)背后的思想。名字里的 Q 是 Quality,也就是“质量”:机器人学的是在任何情况下都做出质量最高的动作,而它把所有情形记成一个简单的马尔可夫过程。
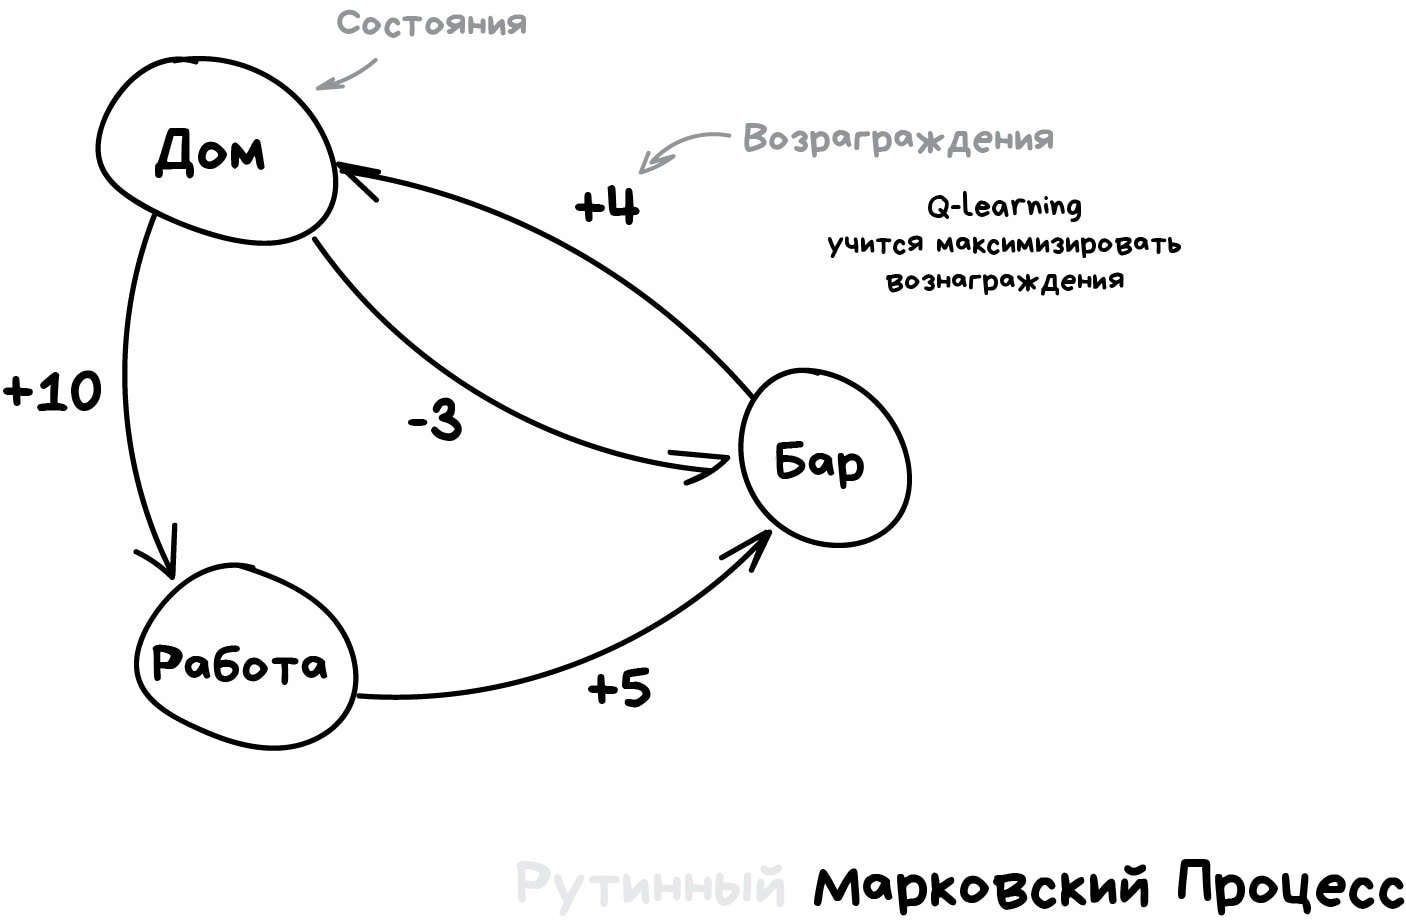
机器在环境里跑几百万次模拟,记住遇到的各种情况,以及哪种应对办法拿到的奖励最多。可怎么知道眼前的是老情况,还是从没见过的新情况?自动驾驶汽车停在路口,绿灯亮了,这就能走了?要是右边正有辆救护车闪着灯冲过来呢?
答案是:鬼知道。没现成办法,也没魔法。研究人员一直在琢磨这事,各想各的土招。有人把各种情况一条条手写进去,这样连电车难题这样的特例也能处理。也有人索性再往深处走,把活儿交给神经网络,让它自己找答案。于是 Q 学习就变成了深度 Q 网络(Deep Q-Network,DQN)。
普通人看强化学习,会觉得这就是真正的智能。因为哇,机器居然会在实际情况里自己拿主意! 这东西现在正火,进展飞快,还在使劲跟神经网络结合,力求再准一点(别逮着同一条椅子腿撞二十回)。
所以,如果你喜欢亲眼看见自己干出来的成果,又想火一把,大胆跳进强化学习这个坑吧(这词的俄语叫法真够别扭的,我每说一次都忍不住哆嗦),再开个 YouTube 频道!连我都会去看。
记得我上学那会儿,遗传算法特别流行(链接里有个挺好玩的可视化)。就是把一堆机器人扔进环境,逼它们朝目标前进,直到死翘翘。然后挑出表现最好的,杂交一下,加点变异,再扔回去。过上个二十来亿年,应该就能搞出个智慧生物来。活生生的进化论。
话说回来,遗传算法也归在强化学习里。它有个头等重要的特点,经过多年实践验证:压根儿没人他妈的需要它。
人类至今没想出一道题,能让它真正比别的方法更有效。倒是很适合当学生实验,不费什么劲就能拿点“成果”哄导师开心。放 YouTube 上也会有人看。
现在来点真家伙。在通往必将到来的技术奇点的路上,集成学习和神经网络是咱们的两员主将。如今,最准的结果是它们给的,各大公司线上用的也是它们。只不过神经网络到哪儿都有人念叨,“boosting”和“bagging”这俩词嘛,大概也就能吓唬吓唬 TechCrunch 那帮潮人。
效果这么好,思路却简单得像在逗你。原来,只要找几个单独看不怎么好用的学习方法,让它们学会纠正彼此的错误,合起来的系统就能比任何一个单打独斗的方法强上一大截。
而且选的算法越不稳定,越容易因为输入变了点就飘得没边儿,效果反倒越好。所以大家常用回归和决策树,数据里冒出一个特别离谱的异常值,就够把整个模型带歪。反而从来不用贝叶斯和 K 近邻,它俩虽然笨,但稳得很。
集成怎么搭都行,你甚至可以随手切几块分类器扔盆里,再浇一勺回归上去。准不准就没人敢打包票了。所以还是讲讲三种经过验证的搭法。
堆叠(Stacking) 训练几个不同的算法,把它们的输出交给最后一个算法,由它拍板。就像姑娘决定要不要跟一个男生交往之前,先把闺蜜们的意见问个遍。
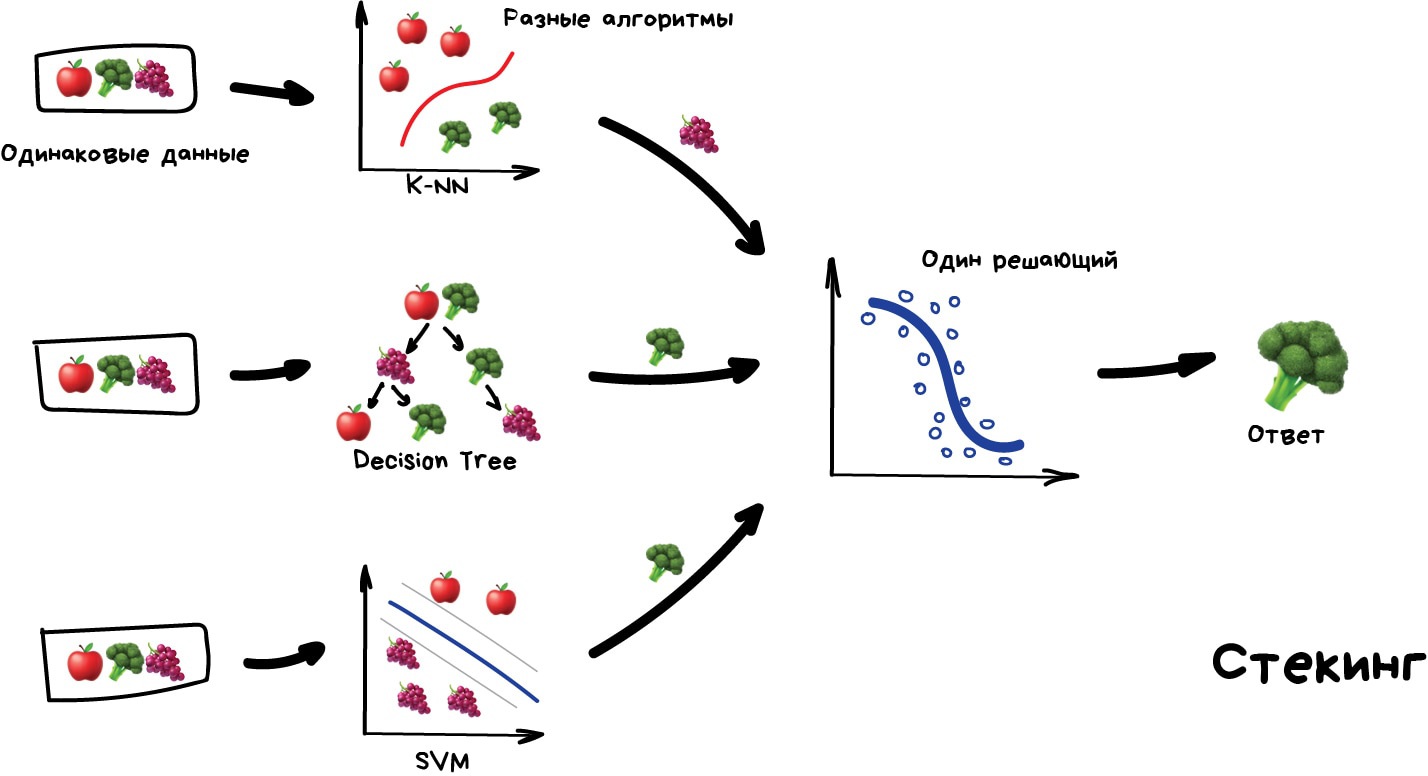
关键词是“不同”的算法。拿同一份数据把同一个算法训练好几次,没什么意思。具体挑哪些,你说了算,不过最后拍板的那个,大家比较常用回归。
就我自己的经验,堆叠在实际项目里不多见,因为另外两种方法通常更准。
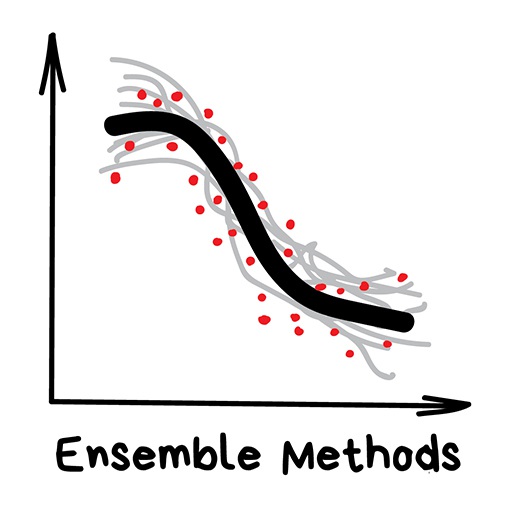
装袋(Bagging) 也就是 Bootstrap AGGregatING。从原始数据里随机抽取多份样本,拿同一个算法反复训练,最后给答案取个平均。
随机抽出来的样本里,数据可以重复。比如从 1-2-3 里可以抽出 2-2-3、1-2-2、3-1-2,想抽多少回都行。用这些样本分别训练同一种算法,最后简单投个票,答案就有了。
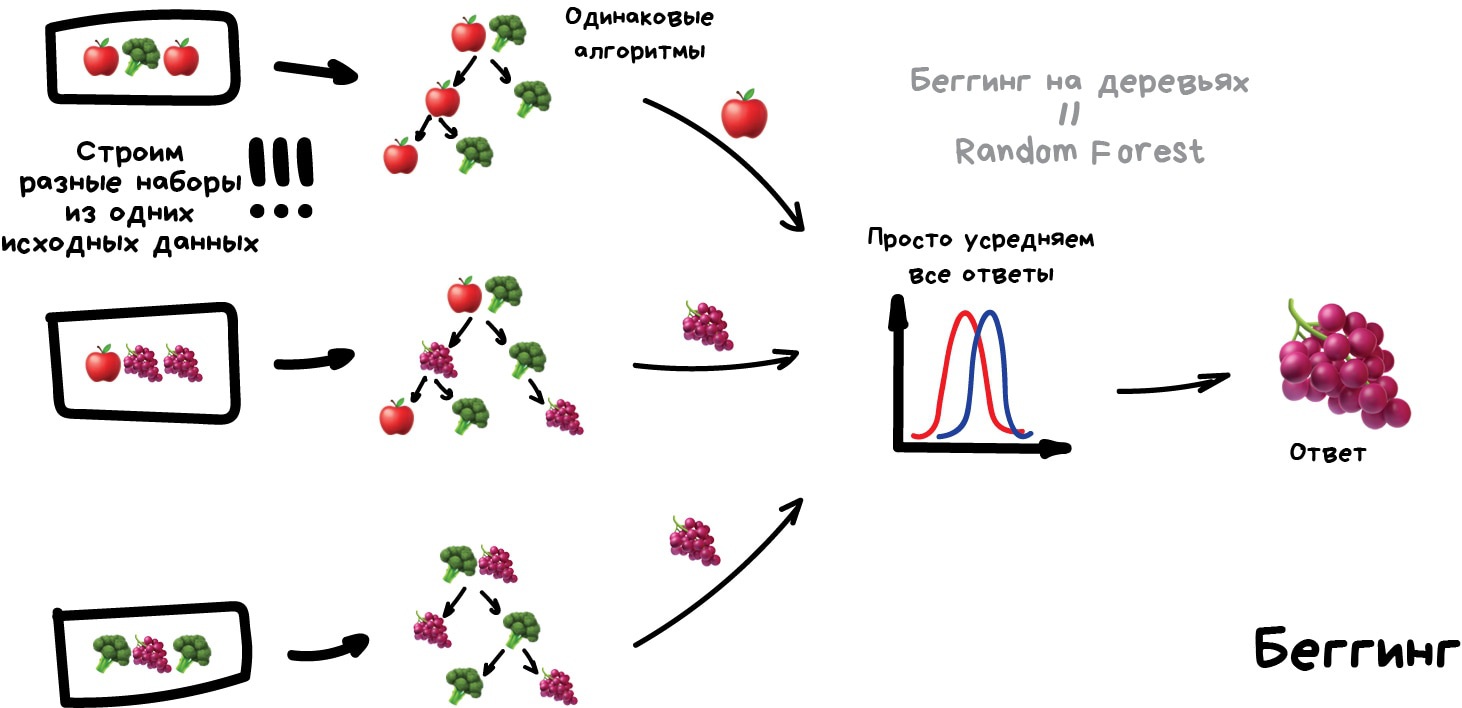
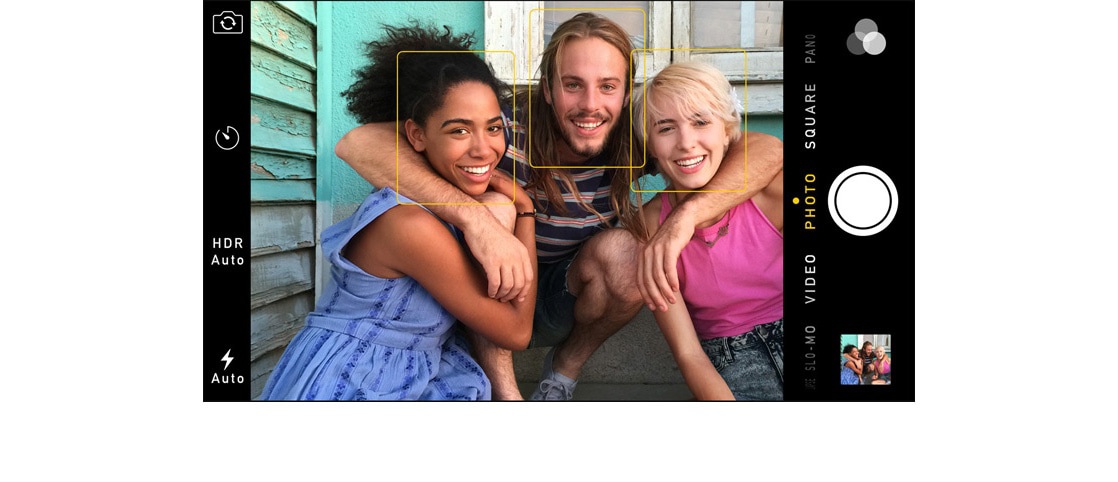
装袋法最有名的例子就是随机森林,也就是图里画的,给决策树做装袋。打开手机相机,看见它用黄色矩形把镜头里的人脸框起来,很可能就是这帮树干的。神经网络要实时跑,动作慢了点,装袋法却正合适,因为它可以让显卡上所有的着色器并行计算这些树。
这么能并行,装袋法甚至比接下来的方法还多了个优势:后者更准,却只能单线程跑。当然也可以切成几段,同时跑几个……嗐,我教谁呢,你们又不是小孩了。
提升(Boosting) 把算法一个接一个地训练,每个后来的都特别留意前一个做错的题。
和装袋法一样,我们也从原始数据里抽样,但这次不完全随机。每一份新样本里,都要放进一部分上一个算法处理错了的数据。也就是说,让新算法拿上一个的错题开小灶。
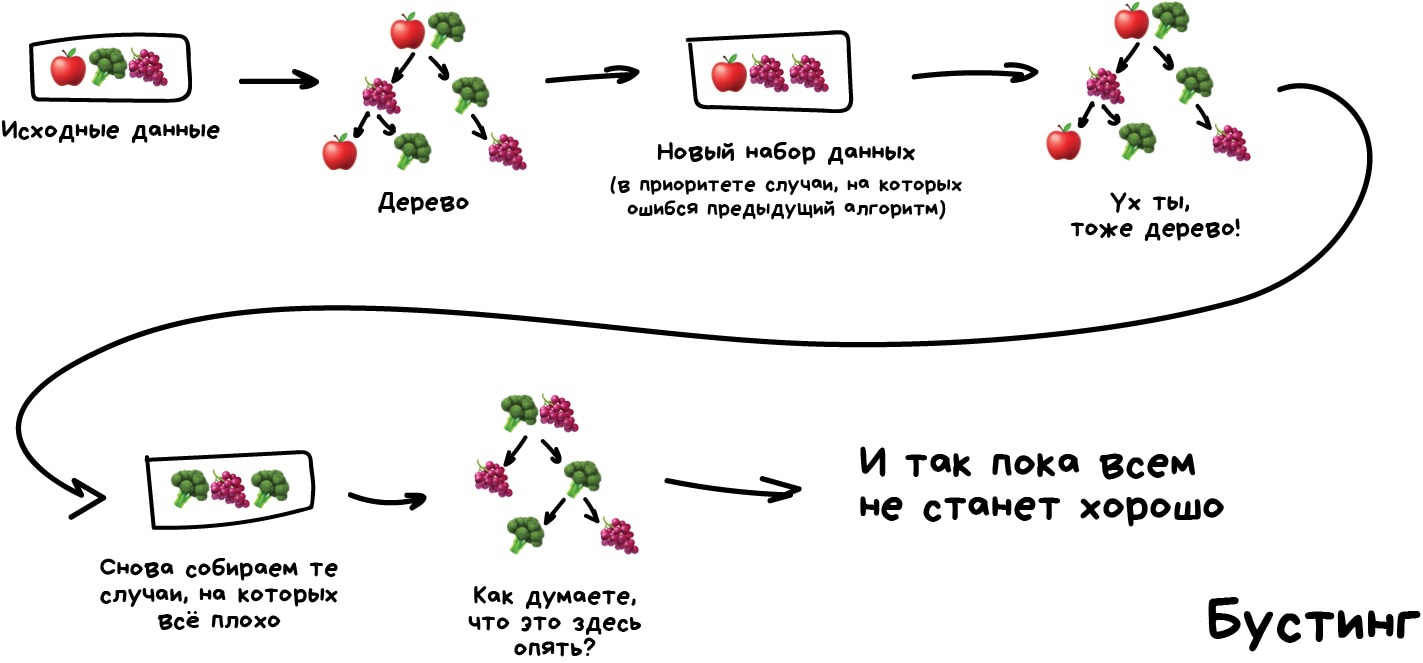
优点:分类准得离谱,准到在某些国家甚至算违法,楼下坐着的大妈们都要眼红。缺点刚说过了:不能并行。不过还是比神经网络快。跟轻快的提升法比,神经网络就像装满沙子的卡玛斯大卡车。
想看看提升法真的跑起来什么样?打开 Yandex,搜点什么。听见没,MatrixNet 正带着一大堆树轰隆隆地给你的搜索结果排序呢。这就是提升法,Yandex 现在全靠它。谷歌用什么我不知道。
如今常用的提升方法有三种,它们的差别,这篇《CatBoost、LightGBM 和 XGBoost 比一比》讲得挺清楚。
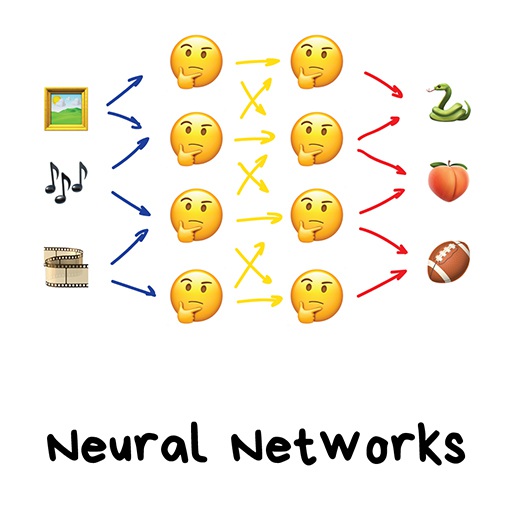
“我们有一千层的网络,几十块显卡,就是还没想出来能拿它干点什么有用的事。让它画猫吧!”
如今用来做这些事:
常用架构:感知机、卷积神经网络(CNN)、循环神经网络(RNN)、自编码器
要是从来没人试着用所谓的“大脑工作原理”给你解释神经网络,告诉我,你是怎么躲过去的?这类比我就不用了,按我喜欢的方式讲吧。
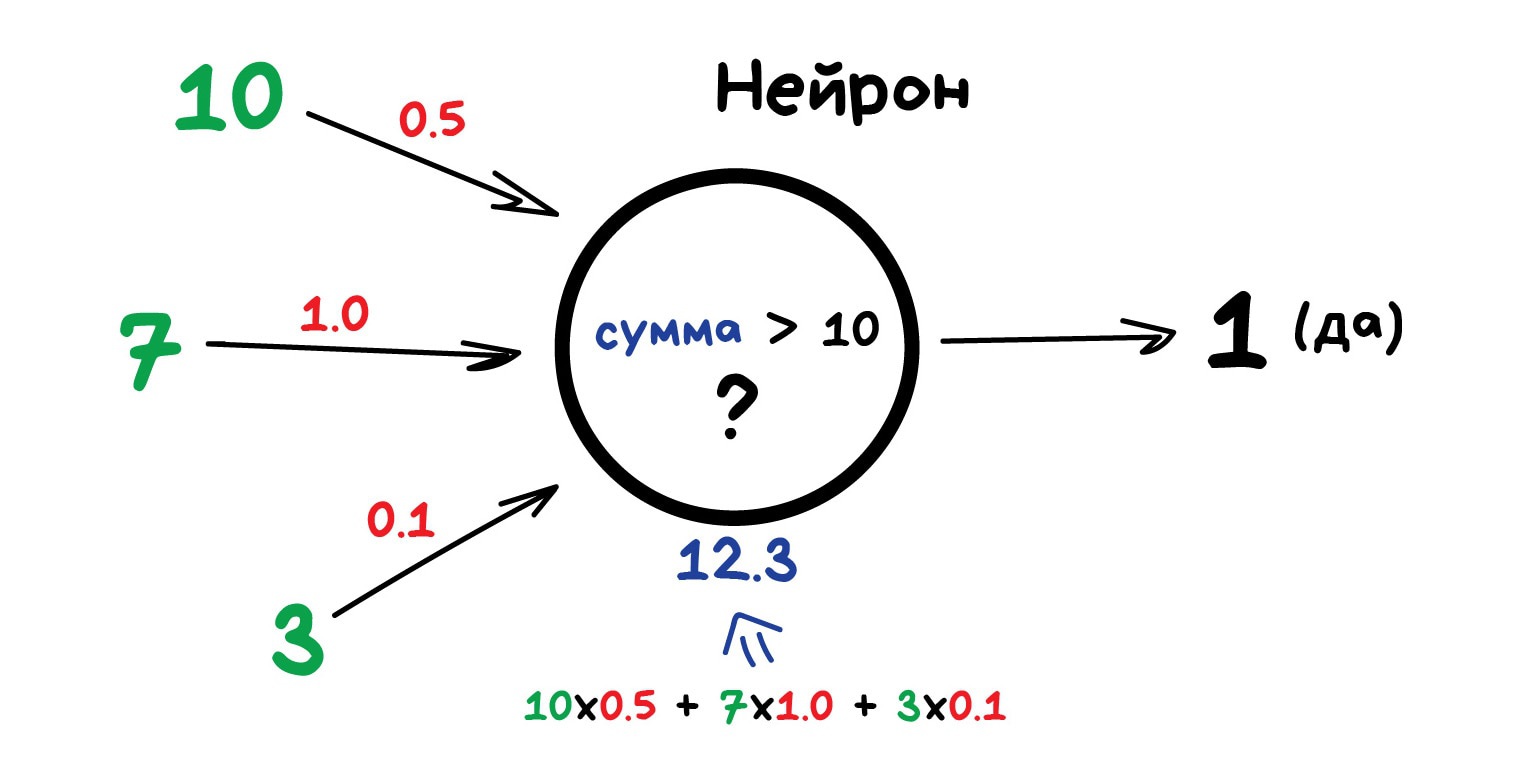
任何神经网络都是一堆神经元,加上它们之间的连接。神经元就把它想成一个函数好了:一堆输入,一个输出。它的活儿就是接过输入的数,算个函数,把结果送到输出端。举个简单又有用的神经元:把输入的数全加起来,总和大于 N 就输出 1,否则输出 0。
连接是神经元之间传数字的通道。每条连接只有一个参数,叫权重,可以粗略理解为连接的强弱。数字 10 经过权重为 0.5 的连接,就变成了 5。神经元自己不管送来的是什么,一股脑全往一块儿加。所以才需要权重,控制它该对哪些输入有反应,哪些可以不理。
为了不让网络乱成一锅粥,人们决定不让神经元想怎么连就怎么连,而是分层连接。同一层里的神经元互不相连,但跟前一层和后一层的神经元相连。数据在这种网络里严格单向流动:从第一层的输入,一路到最后一层的输出。
只要层数堆得够多,权重放得够准,就会发生这么一件事:比如往输入端送一张手写数字 4 的图,黑像素会激活与之相连的神经元,它们再激活后面的层,就这么一层接一层,最后,负责报“四”的那个输出端亮了。搞定。
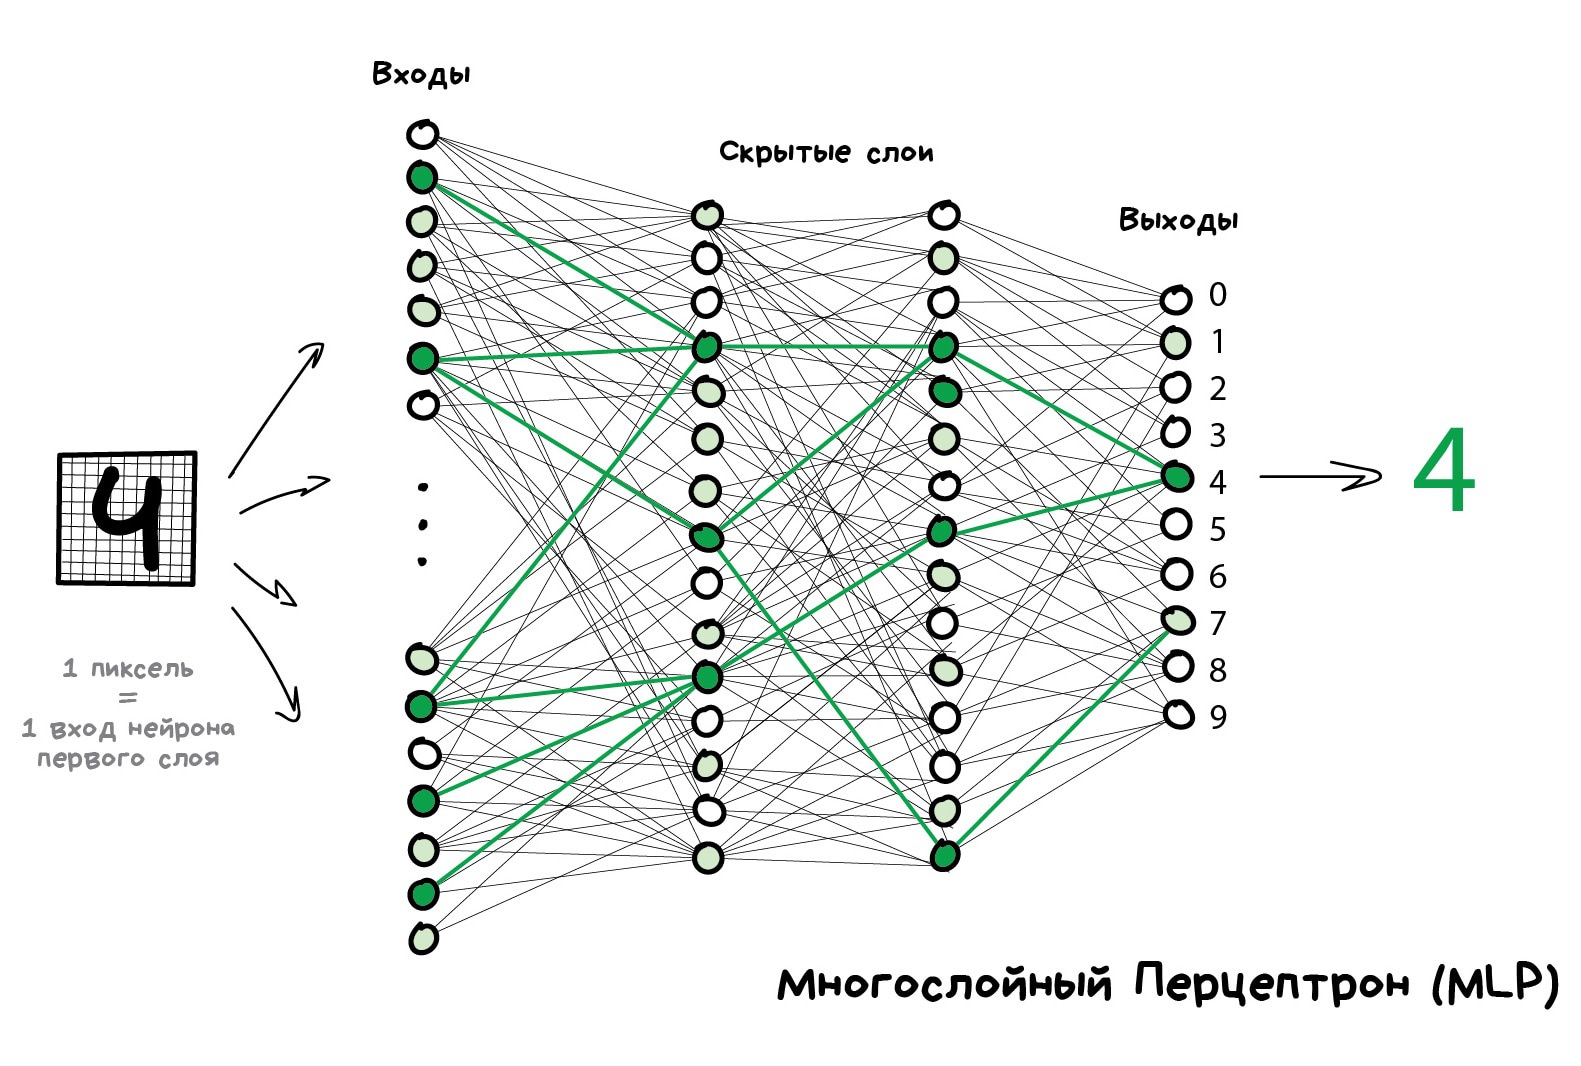
真的写程序时,当然没人一个个去写神经元和连接。为了速度,大家把它们都写成矩阵,用矩阵乘法来算。我特别喜欢两个视频,用识别手写数字做例子,把我刚讲的这套过程直观地演了一遍。想弄明白就看看。
这种网络有好几层,相邻两层的神经元两两相连,叫多层感知机(MLP),被认为是最简单的入门架构。我自己倒是从没在实际项目里碰到过它。
网络搭好了,接下来得把权重调对,让神经元对该响应的信号有反应。别忘了我们手上有数据:有“输入”的例子,也有正确的“输出”。还是把那张手写的 4 给网络看,跟它说:“调调你的权重,今后只要看到这样的输入,输出端的四就得亮。”
起初权重都是随机放的。给网络看个数字,它随口蒙个答案(权重还没学呢),我们就看看这答案跟想要的差多远。然后沿着网络倒回去,从输出往输入走,挨个跟神经元说:喂,你刚才不知道为啥就激活了,打你这儿往后全歪了。下回你对这条连接少反应一点,对那条多反应一点,行不?
这样“跑一遍、查一遍、罚一遍”来个十万轮,网络里的权重就有希望调成我们想要的样子。这种做法的学名是反向传播(Backpropagation),全称“误差反向传播法”。有意思的是,人们花了二十年才想出这招。在它之前,训练神经网络就只能各显神通。
我喜欢的第二个视频把整个过程讲得更细,不过一样是掰开揉碎了说,很好懂。
训练得好的神经网络,能扮成本文讲到的任何一种算法,而且往往还能算得更准。正是这种什么都能干的本事,让它一下子红透了。我们终于有了人脑的架构,他们说。只要多堆几层,拿什么数据都能训练,他们满怀希望。然后,第一场人工智能寒冬来了,后来解了冻,再后来又是一波失望。
原来,要训练很多层的网络,需要的算力在当年根本不可能有。今天随便一台插着 GeForce 显卡的破游戏机,算力都超过当时的一整个数据中心。可在当年连个盼头都没有,于是大家对神经网络失望透顶。
直到大约十年前,深度学习炸了场。
英文维基百科有个机器学习时间线,哪会儿大家欢天喜地,哪会儿又集体绝望,看得一清二楚。
2012 年,卷积神经网络在 ImageNet 比赛中碾压全场,全世界这才突然想起,早在 90 年代就有人写过深度学习的方法。现在咱们可是有显卡了!
深度学习跟经典神经网络的区别,原本在于有了新的训练方法,能对付更大的网络。可今天也就理论派还会区分哪种学习算深,哪种不太深。我们这些干活的人,哪怕只是搭个五层的小网络,也照用 Keras、TensorFlow、PyTorch 这些流行的“深度”学习库。原因很简单:比以前那些东西好用。我们就管它叫神经网络。
讲讲眼下最主要的两种。
卷积网络现在正当红。在照片和视频里找物体、识别人脸、迁移风格、生成图像、把图里缺的部分补全、做慢动作之类的特效、改善照片画质,都用得上它。现在凡是有图片或视频的地方,都有人用 CNN。连你的 iPhone 里都有好几个这样的网络,在看你的裸照,好认出里面有什么东西。当然,前提是有东西可认,嘿嘿嘿。
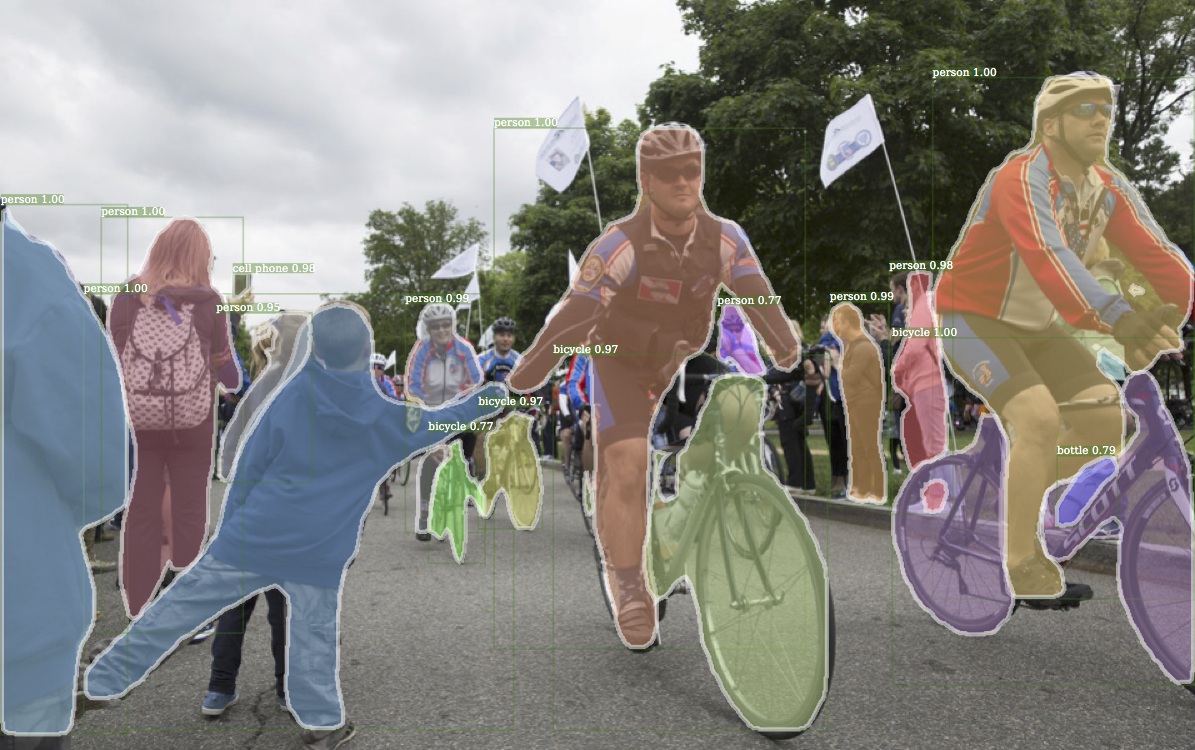
上图是 Detectron 库跑出来的结果,Facebook 最近刚把它开源。
图像一直有个难点:不知道该怎么从里面提取特征。文本可以拆成句子,可以查词典拿到词的属性。图片却得手工标注,要告诉机器,照片上小猫的耳朵在哪儿、尾巴在哪儿。这种办法还有个名字,叫“手工设计特征”,以前大家都是这么干的。
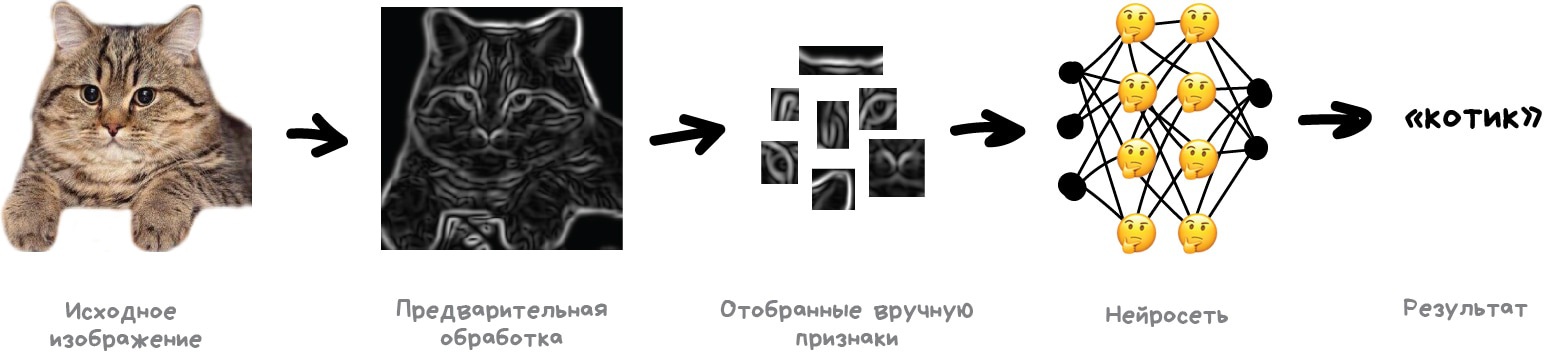
手搓特征的问题可不少。
第一,照片里的小猫要是把耳朵贴平了,或者转过头去,那就完了,神经网络什么也认不出来。
第二,你现在就试试,说出至少十个能把猫和其他动物区分开的典型特征。我反正说不出。可夜里一个黑影从我身边蹿过去,哪怕眼角只瞥到一下,我也知道是猫还是老鼠。人看的不只是耳朵什么形状、有几条腿,而是同时掂量了一大堆自己压根没意识到的特征。自己都没搞清楚,当然也没法讲给机器听。
这就意味着,机器得自己学着从一些最基本的线条里拼出特征。咱们这么办:先把图像切成 8×8 像素的小块,看看每一块里哪种线条最明显,是横线 [-]、竖线 [|],还是某个方向的斜线 [/]。也可能有两种、三种都挺明显,这很正常,我们也不总能拿准。
输出就是好几个由小线段组成的数组。这些线段其实就是图中存在物体轮廓的最简单的特征。说白了,这些也是图,只不过是小线段拼的。那我们就能再取一个 8×8 的块,这次看的是这些线段彼此怎么组合。然后再来一遍,再来一遍。
这种操作叫“卷积”,这个方法的名字就是这么来的。卷积可以表示成神经网络里的一层,毕竟神经元可以是任意函数。
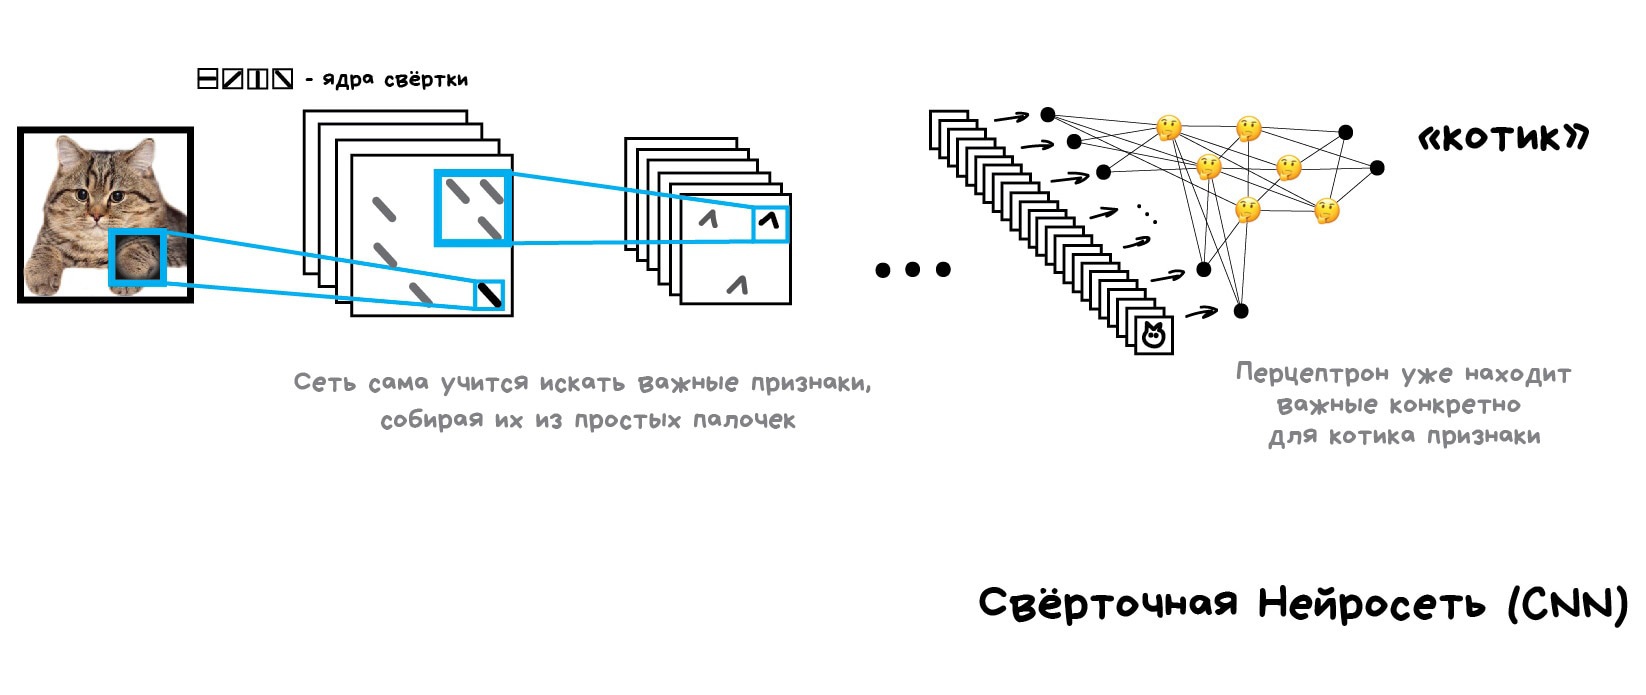
让一大堆猫片从网络里过一遍,它就会自动给那些最常见的线段组合分配更高的权重。是猫背上一条直线,还是猫脸那样复杂的几何形状,并不重要,总有东西会被强烈激活。
在输出端,咱们放个简单的感知机,看哪些组合被激活了,再说说这些组合更像谁——猫还是狗。
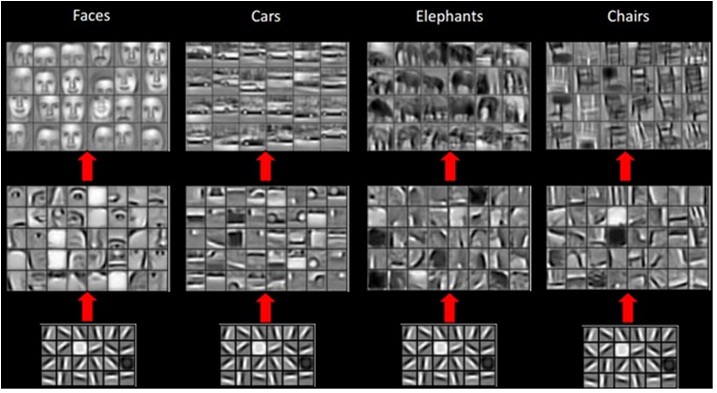
这主意妙就妙在,咱们得到的网络会自己找物体的典型特征,用不着人动手挑了。随便选个东西,去谷歌搜一百万张它的图,想喂多少喂多少。网络自己会用线段拼出特征图,什么东西都能学着认。
说到这个,我还有个不好笑的笑话:
授神经网络以鱼,它一辈子都会认鱼。授神经网络以渔竿,它一辈子也都会认渔竿……
这是目前受欢迎程度排第二的架构。有了循环网络,我们才有了文本机器翻译(这事我写过一篇)、计算机语音合成这些有用的东西。凡是跟序列有关的问题都有人拿它来做,不管是语音、文本还是音乐。
还记得那些老式语音合成器吗?比如 Windows XP 里的 Microsoft Sam,一个字母一个字母往外念,再想办法把它们粘成词,听着怪好笑的。再听听亚马逊的 Alexa 或者 Yandex 的语音助手 Alice。现在它们不光单词念不错,连一句话该重读哪儿都知道!
因为现在教语音助手说话,不是逐个字母教,而是按整句教。可你不能让神经网络一口气输出一整句成品,不然它就得把这门语言里所有能说的话全记下来,个头非得大得吓人。这时有一点帮了忙:无论文本、语音还是音乐,都是序列。每个词、每个音,既是独立的单位,又跟之前的单位有关。把这层联系弄没了,出来的就是 dubstep 了。
光教网络念出单个词或字母倒不难。找一堆按词标好的音频文件,训练网络,让它看到一个输入词就输出一串信号,听起来像那个词的发音。跟播音员的原声比一比,尽量往标准答案靠。这个活儿连感知机都能干。
可碰到连着的一串,又麻烦了:感知机不记得刚才生成过什么。对它来说,每次运行都是头一回。于是有人想到,给每个神经元加点记忆。这就有了循环网络:每个神经元记住自己之前的所有答案,下次运行时拿它们当额外输入。相当于神经元可以给未来的自己留句话:“兄弟,刚才是个元音,下个音得念高点。”(这是个极度简化的例子。)
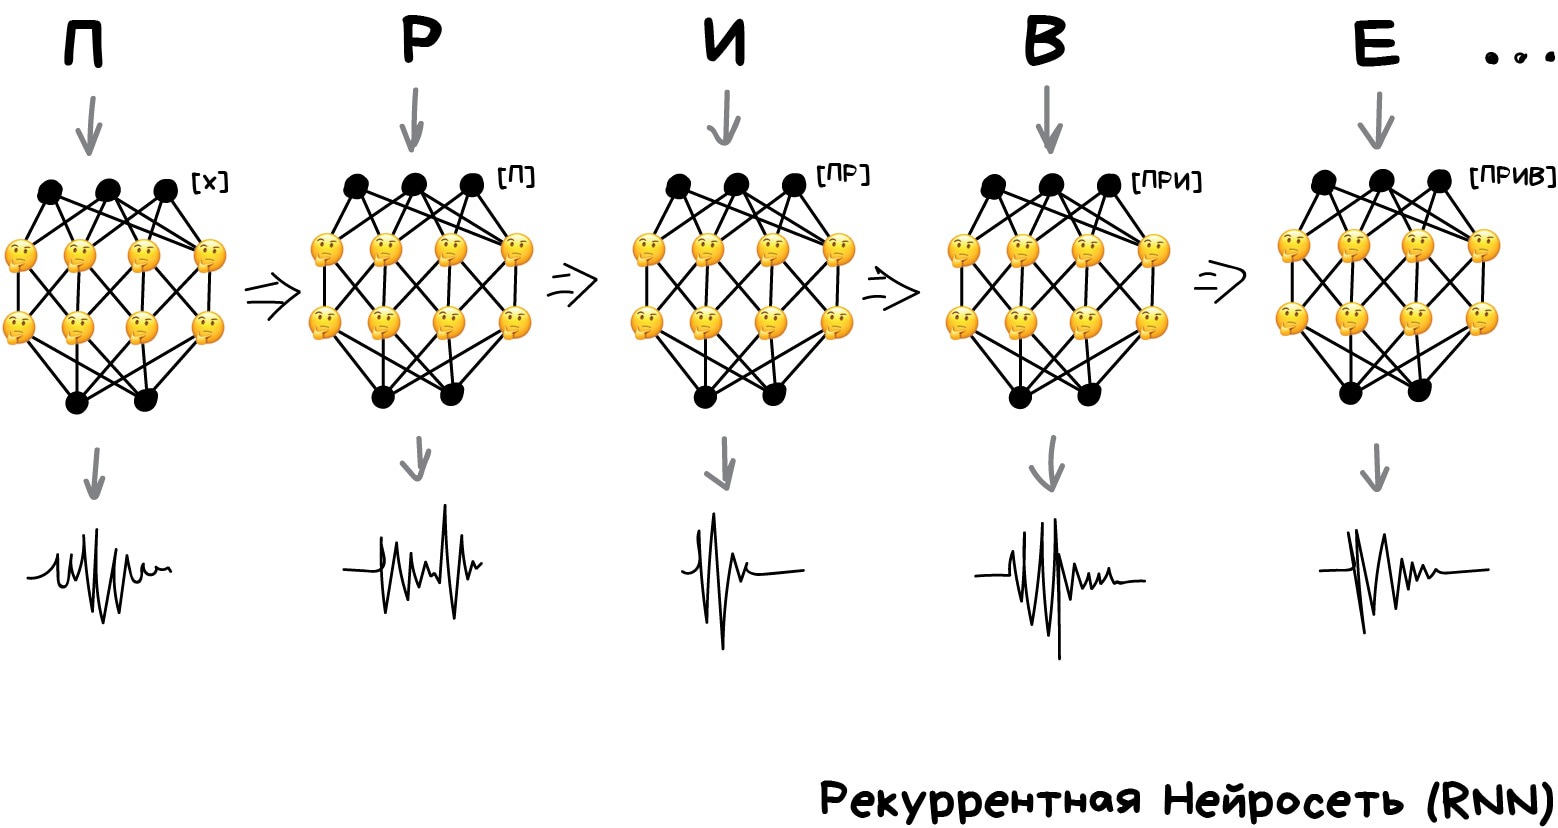
只有一个问题:每个神经元都把过去的所有结果记下来之后,网络里的输入多到了离谱的地步,这么一大堆连接根本没法训练。
神经网络要是学不会忘,就什么也学不会(人也有这毛病)。
最初的办法简单粗暴:把每个神经元的记忆截短。后来有人想出用专门的单元来充当“记忆”,有点像计算机内存或者处理器的寄存器。每个单元都能写入一个数、读出来,或者清零。这就叫长短期记忆(LSTM)单元。
神经元要给将来的自己留个提醒,就往单元里写。反过来,前面的事都不用记了(比如一句话说完了),就把单元清零,只留下经典感知机里也有的那种“长期”连接。换句话说,网络学的不只是怎么调眼下的连接,还学会了给自己设提醒。
简单,但管用!
有朗读录音的文本,哪儿都能拿来当训练素材。连 BuzzFeed 都能把奥巴马的演讲视频扒下来,教神经网络用他的嗓音说话,学得还挺像。这个例子也看得出,模仿声音对今天的机器来说已经是个挺简单的活儿了。视频难一点,不过也就是暂时的。

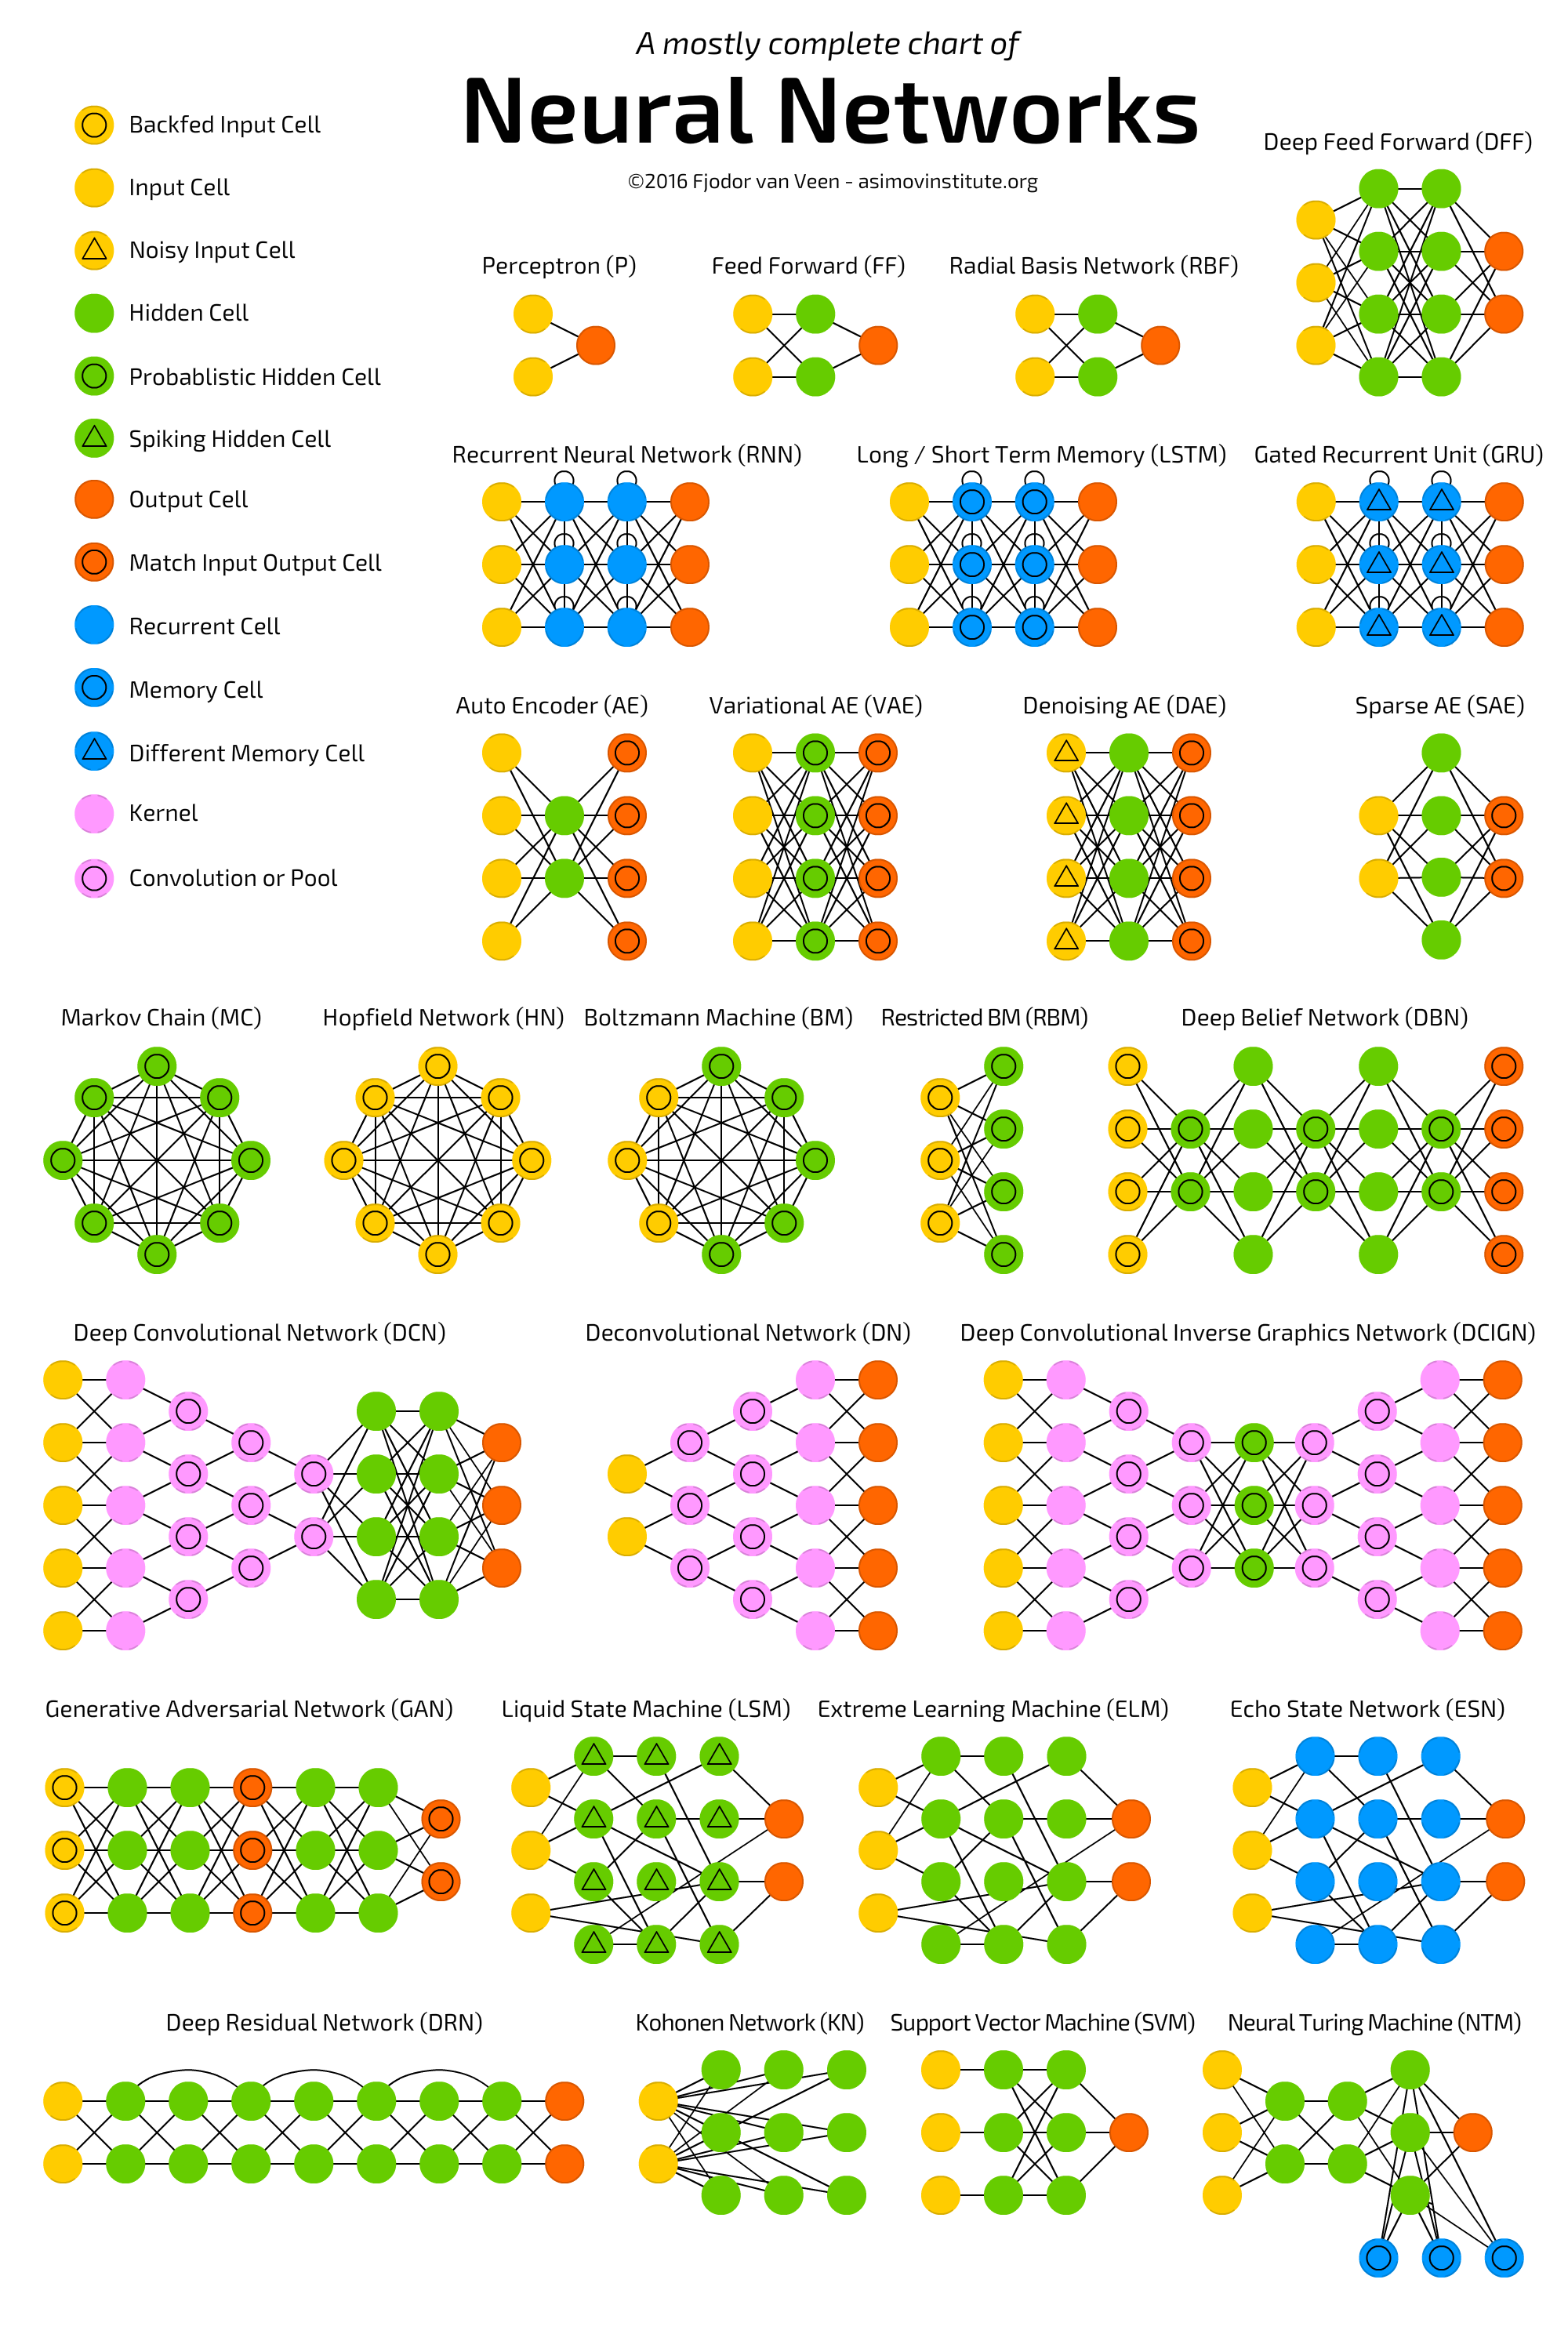
神经网络的架构,真能没完没了地讲下去。好奇的朋友去看图,再读读《神经网络动物园》,里面把各种神经网络都收齐了。还有俄语版。
本文也有英文版
机器学习就像高中生聊性:人人都在角落里议论,真懂的没几个,真在做的只有老师。讲机器学习的文章分两种:一种是塞满公式和定理的三卷本,我哪次都没能读到一半;另一种是关于人工智能、未来职业和神通广大的数据科学家的童话。
我决定自己动手,把我一直想看却没找到的文章写出来。这是一篇长篇入门,写给想把机器学习搞明白的人:说人话,不堆公式定理,多讲讲现实里碰到什么问题,又是怎么解决的。
走起。
📔 下载 PDF、EPUB、MOBI
方便离线阅读 ❤️ 谢谢作者